В розділі "Концепції" описані складові системи Kubernetes і абстракції, за допомогою яких Kubernetes реалізовує ваш кластер. Цей розділ допоможе вам краще зрозуміти, як працює Kubernetes.
Загальна інформація
Для роботи з Kubernetes ви використовуєте об'єкти API Kubernetes для того, щоб описати бажаний стан вашого кластера: які застосунки або інші робочі навантаження ви плануєте запускати, які образи контейнерів вони використовують, кількість реплік, скільки ресурсів мережі та диску ви хочете виділити тощо. Ви задаєте бажаний стан, створюючи об'єкти в Kubernetes API, зазвичай через інтерфейс командного рядка kubectl. Ви також можете взаємодіяти із кластером, задавати або змінювати його бажаний стан безпосередньо через Kubernetes API.
Після того, як ви задали бажаний стан, площина управління Kubernetes приводить поточний стан кластера до бажаного за допомогою Pod Lifecycle Event Generator (PLEG). Для цього Kubernetes автоматично виконує ряд задач: запускає або перезапускає контейнери, масштабує кількість реплік у певному застосунку тощо. Площина управління Kubernetes складається із набору процесів, що виконуються у вашому кластері:
Kubernetes master становить собою набір із трьох процесів, запущених на одному вузлі вашого кластера, що визначений як керівний (master). До цих процесів належать: kube-apiserver, kube-controller-manager і kube-scheduler.
На кожному не-мастер вузлі вашого кластера виконуються два процеси:
kubelet, що обмінюється даними з Kubernetes master.
kube-proxy, мережевий проксі, що відображає мережеві сервіси Kubernetes на кожному вузлі.
Об'єкти Kubernetes
Kubernetes оперує певною кількістю абстракцій, що відображають стан вашої системи: розгорнуті у контейнерах застосунки та робочі навантаження, пов'язані з ними ресурси мережі та диску, інша інформація щодо функціонування вашого кластера. Ці абстракції представлені як об'єкти Kubernetes API. Для більш детальної інформації ознайомтесь з Об'єктами Kubernetes.
В Kubernetes є також абстракції вищого рівня, які надбудовуються над базовими об'єктами за допомогою контролерів і забезпечують додаткову функціональність і зручність. До них належать:
Площина управління Kubernetes (Kubernetes Control Plane)
Різні частини площини управління Kubernetes, такі як Kubernetes Master і kubelet, регулюють, як Kubernetes спілкується з вашим кластером. Площина управління веде облік усіх об'єктів Kubernetes в системі та безперервно, в циклі перевіряє стан цих об'єктів. У будь-який момент часу контрольні цикли, запущені площиною управління, реагуватимуть на зміни у кластері і намагатимуться привести поточний стан об'єктів до бажаного, що заданий у конфігурації.
Наприклад, коли за допомогою API Kubernetes ви створюєте Deployment, ви задаєте новий бажаний стан для системи. Площина управління Kubernetes фіксує створення цього об'єкта і виконує ваші інструкції шляхом запуску потрібних застосунків та їх розподілу між вузлами кластера. В такий спосіб досягається відповідність поточного стану бажаному.
Kubernetes Master
Kubernetes Master відповідає за підтримку бажаного стану вашого кластера. Щоразу, як ви взаємодієте з Kubernetes, наприклад при використанні інтерфейсу командного рядка kubectl, ви обмінюєтесь даними із Kubernetes master вашого кластера.
Слово "master" стосується набору процесів, які управляють станом кластера. Переважно всі ці процеси виконуються на одному вузлі кластера, який також називається master. Master-вузол можна реплікувати для забезпечення високої доступності кластера.
Вузли Kubernetes
Вузлами кластера називають машини (ВМ, фізичні сервери тощо), на яких запущені ваші застосунки та хмарні робочі навантаження. Кожен вузол керується Kubernetes master; ви лише зрідка взаємодіятимете безпосередньо із вузлами.
Що далі
Якщо ви хочете створити нову сторінку у розділі Концепції, у статті
Використання шаблонів сторінок
ви знайдете інформацію щодо типу і шаблона сторінки.
1 - Вузли
Kubernetes виконує ваше робоче навантаження шляхом розміщення контейнерів у Podʼах для запуску на вузлах. Вузол може бути віртуальною або фізичною машиною, залежно від кластера. Кожен вузол керується панеллю управління і містить необхідні служби для запуску Podʼів.
Зазвичай в кластері є кілька вузлів; в умовах навчання чи обмежених ресурсів може бути всього один вузол.
Є два основних способи додавання вузлів до API-сервера:
kubelet на вузлі самостійно реєструється в панелі управління.
Ви (або інший користувач) вручну додаєте обʼєкт Node.
Після створення обʼєкта Node або якщо kubelet на вузлі самостійно реєструється, панель управління перевіряє, чи новий обʼєкт Node є дійсним. Наприклад, якщо ви спробуєте створити вузол із таким JSON-маніфестом:
Kubernetes внутрішньо створює обʼєкт Node (його представлення). Kubernetes перевіряє, чи kubelet, що відповідає полю metadata.name обʼєкта Node, зареєструвався в API-сервері. Якщо вузол є справним (тобто всі необхідні служби працюють), то він може запускати Podʼи. В іншому випадку цей вузол ігнорується для будь-якої діяльності кластера, доки він не стане справним.
Примітка:
Kubernetes зберігає обʼєкт для недійсного вузла та продовжує перевіряти, чи він стає справним.
Ви або контролер маєте явно видалити обʼєкт Node, щоб припинити цю перевірку його справності.
Назва ідентифікує Node. Два вузли не можуть мати однакову назву одночасно. Kubernetes також припускає, що ресурс із такою самою назвою — це той самий обʼєкт. У випадку вузла припускається неявно, що екземпляр, який використовує ту саму назву, матиме той самий стан (наприклад, мережеві налаштування, вміст кореневого диска) та атрибути, такі як мітки вузла. Це може призвести до невідповідностей, якщо екземпляр був змінений без зміни його назви. Якщо вузол потрібно замінити або значно оновити, наявний обʼєкт Node потрібно спочатку видалити з API-сервера, а після оновлення додати знову.
Самореєстрація вузлів
Коли прапорець kubelet --register-node є true (типово), kubelet спробує зареєструвати себе в API-сервері. Це бажаний підхід, який використовується більшістю дистрибутивів.
Для самореєстрації kubelet запускається з такими параметрами:
--kubeconfig — Шлях до облікових даних для автентифікації на API-сервері.
--cloud-provider — Як взаємодіяти з хмарним провайдером для отримання метаданих про себе.
--register-node — Автоматична реєстрація в API-сервері.
Нічого не відбувається, якщо register-node є false.
--node-ip — Необовʼязковий розділений комами список IP-адрес вузла. Можна вказати лише одну адресу для кожного сімейства адрес. Наприклад, у кластері з одним стеком IPv4 ви встановлюєте це значення як IPv4-адресу, яку повинен використовувати kubelet для вузла. Див. Налаштування подвійного стека IPv4/IPv6 для отримання відомостей про запуск кластера з подвійним стеком.
Якщо ви не вказали цей аргумент, kubelet використовує стандартну IPv4-адресу вузла, якщо є; якщо у вузла немає адреси IPv4, тоді kubelet використовує стандартну IPv6-адресу вузла.
Як зазначено в розділі Унікальність назв вузлів, коли потрібно оновити конфігурацію вузла, доброю практикою є повторна реєстрація вузла в API-сервері. Наприклад, якщо kubelet перезапускається з новим набором --node-labels, але використовується та сама назва Node, зміна не набуде чинності, оскільки мітки встановлюються (або змінюються) лише під час реєстрації вузла в API-сервері.
Podʼи, вже заплановані на Node, можуть погано поводитися або викликати проблеми, якщо конфігурація Node буде змінена при перезапуску kubelet. Наприклад, вже запущений Pod може виявитися несумісним із новими мітками, призначеними вузлу, тоді як інші Podʼи, несумісні з цим Podʼом, будуть заплановані на основі цієї нової мітки. Перереєстрація вузла гарантує, що вузол буде очищено від усіх Podʼів і їх буде належним чином переплановано.
Ручне адміністрування вузлів
Ви можете створювати та змінювати обʼєкти Node за допомогою kubectl.
Коли ви хочете створювати обʼєкти Node вручну, встановіть прапорець kubelet --register-node=false.
Ви можете змінювати обʼєкти Node незалежно від налаштувань --register-node. Наприклад, ви можете встановлювати мітки на наявному вузлі або позначати його як непридатний для планування.
Ви можете встановити необовʼязкові ролі для вузлів, додавши одну або кілька міток node-role.kubernetes.io/<role>: <role> до вузла, де символи <role> обмежуються правилами синтаксису для міток.
Kubernetes ігнорує значення мітки для ролей вузлів; за домовленістю, ви можете задати для неї той самий рядок, який ви використовували для ролі вузла у ключі мітки.
Ви можете використовувати мітки на вузлах разом із селекторами вузлів на Podʼах для управління плануванням. Наприклад, ви можете дозволити Podʼу запускатися лише на підмножині доступних вузлів.
Позначення вузла як непридатного для планування перешкоджає планувальнику розміщувати нові Podʼи на цьому вузлі, але не впливає на наявні Podʼи на вузлі. Це корисно як підготовчий крок перед перезавантаженням вузла чи іншим обслуговуванням.
Щоб позначити вузол як непридатний для планування, виконайте:
Podʼи, які є частиною DaemonSet, толерують запуск на вузлі, непридатному для планування. Зазвичай DaemonSets надають служби, локальні для вузла, які мають працювати на ньому, навіть якщо він очищується від робочих навантажень.
Обʼєкти Lease у просторі іменkube-node-lease. Кожен вузол має асоційований обʼєкт Lease.
Контролер вузлів
Контролер вузлів — це компонент панелі управління Kubernetes, який керує різними аспектами роботи вузлів.
У контролера вузлів є кілька ролей у житті вузла. По-перше, він призначає блок CIDR вузлу при його реєстрації (якщо призначення CIDR увімкнено).
По-друге, він підтримує актуальність внутрішнього списку вузлів контролера зі списком доступних машин хмарного провайдера. Під час роботи в хмарному середовищі, коли вузол несправний, контролер вузлів запитує в хмарного провайдера, чи ще доступна віртуальна машина (VM) для цього вузла. Якщо ні, контролер вузлів видаляє вузол зі свого списку вузлів.
По-третє, він відстежує справність вузлів. Контролер вузлів відповідає за:
У випадку, якщо вузол стає недоступним, оновлення умови Ready у полі .status вузла. У цьому випадку контролер вузлів встановлює умову Ready в Unknown.
Якщо вузол залишається недоступним: запуск виселення, ініційоване API для всіх Podʼів на недосяжному вузлі. Типово контролер вузлів чекає 5 хвилин між позначенням вузла як Unknown та поданням першого запиту на виселення.
Стандартно контролер вузлів перевіряє стан кожного вузла кожні 5 секунд. Цей період можна налаштувати за допомогою прапорця --node-monitor-period у компоненті kube-controller-manager.
Обмеження швидкості виселення
У більшості випадків контролер вузлів обмежує швидкість виселення до --node-eviction-rate (типово 0,1) за секунду, тобто він не виселятиме Podʼи більш ніж з 1 вузла за 10 секунд.
Поведінка виселення змінюється, коли вузол у певній зоні доступності стає несправним. Контролер вузлів перевіряє, яка частина вузлів в зоні є несправною (умова Ready — Unknown або False) у той самий час:
Якщо частка несправних вузлів становить принаймні --unhealthy-zone-threshold (типово 0,55), тоді швидкість виселення зменшується.
Якщо кластер малий (тобто має не більше ніж --large-cluster-size-threshold вузлів — типово 50), тоді виселення припиняється.
В іншому випадку швидкість виселення зменшується до --secondary-node-eviction-rate (типово 0,01) в секунду.
Причина того, що ці політики реалізовані окремо для кожної зони доступності, полягає в тому, що одна зона може втратити зʼєднання з панеллю управління, тоді як інші залишаються підключеними. Якщо ваш кластер не охоплює кілька зон доступності хмарного провайдера, тоді механізм виселення не враховує недоступність окремих зон.
Однією з ключових причин розподілу вузлів за зонами доступності є можливість переміщення навантаження в справні зони, коли одна ціла зона виходить з ладу. Таким чином, якщо всі вузли в зоні несправні, контролер вузлів виселяє Podʼи зі звичайною швидкістю --node-eviction-rate. Крайній випадок — коли всі зони повністю несправні (жоден вузол в кластері не є справним). У такому випадку контролер вузлів припускає, що існує якась проблема зі зʼєднанням між панеллю управління та вузлами, і не виконує жодних виселень. (Якщо стався збій і деякі вузли відновились, контролер вузлів виселяє Podʼи з решти вузлів, які є несправними або недосяжними).
Контролер вузлів також відповідає за виселення Podʼів, що працюють на вузлах із taints NoExecute, якщо ці Podʼи не толерують цей taint. Контролер вузлів також додає taints, відповідні проблемам вузла, таким як недосяжність вузла або неготовність вузла. Це означає, що планувальник не розміщуватиме Podʼи на несправних вузлах.
Відстеження місткості ресурсів
Обʼєкти Node відстежують інформацію про ресурсну місткість вузла: наприклад, кількість доступної памʼяті та кількість процесорів. Вузли, які реєструються самостійно, повідомляють про свою місткість під час реєстрації. Якщо ви додаєте вузол вручну, то вам потрібно встановити інформацію про місткість вузла при його додаванні.
Планувальник Kubernetes забезпечує, що на вузлі є достатньо ресурсів для всіх Podʼів. Планувальник перевіряє, що сума запитів контейнерів на вузлі не перевищує місткості вузла. Ця сума запитів включає всі контейнери, керовані kubelet, але не включає жодні контейнери, запущені безпосередньо середовищем виконання контейнерів, а також виключає будь-які процеси, які працюють поза контролем kubelet.
This is a stable feature in Kubernetes, and has been since the 1.27 release. You can no longer toggle this feature (the associated feature gate has been removed).
Якщо ви увімкнули функціональну можливість TopologyManager, то kubelet може використовувати підказки топології при прийнятті рішень щодо призначення ресурсів. Див. Керування політиками топології на вузлі для отримання додаткової інформації.
Цей документ описує шляхи звʼязку між API-сервером та кластером Kubernetes. Мета — надати користувачам можливість налаштувати своє встановлення та посилити конфігурацію мережі так, щоб кластер можна було запускати в ненадійній мережі (або на повністю публічних IP-адресах у хмарному середовищі).
Звʼязок вузла з панеллю управління
У Kubernetes існує шаблон API "hub-and-spoke". Усе використання API з боку вузлів (або Podʼів, які на них працюють) завершується на API-сервері. Інші компоненти панелі управління не призначені для надання віддалених сервісів. API-сервер налаштований для прослуховування віддалених підключень на захищеному порту HTTPS (зазвичай 443) з однією або кількома увімкненими формами автентифікації клієнта. Рекомендується увімкнути одну чи кілька форм авторизації, особливо якщо анонімні запити або токени службового облікового запису дозволені.
Вузли повинні бути забезпечені публічним кореневим сертифікатом для кластера, щоб вони могли безпечно підключатися до API-сервера разом з дійсними обліковими даними клієнта. Добрий підхід — надавати kubelet облікові дані клієнта у формі клієнтського сертифіката. Див. завантаження TLS kubelet для автоматичного надання клієнтських сертифікатів kubelet.
Podʼи, які бажають підʼєднатися до API-сервера, можуть це зробити безпечно, використовуючи службовий обліковий запис (service account), так що Kubernetes автоматично вставлятиме публічний кореневий сертифікат та дійсний токен на предʼявника у Pod під час його створення. Service kubernetes (у просторі імен default) налаштована з віртуальною IP-адресою, яка перенаправляється (через kube-proxy) на точку доступу HTTPS на API-сервері.
Компоненти панелі управління також взаємодіють з API-сервером через захищений порт.
У результаті типовий режим роботи для зʼєднань від вузлів та Podʼів, що працюють на вузлах, до панелі управління є захищеним і може працювати через ненадійні та/або публічні мережі.
Звʼязок панелі управління з вузлом
Існують два основних шляхи звʼязку панелі управління (API-сервера) з вузлами. Перший — від API-сервера до процесу kubelet, який працює на кожному вузлі в кластері. Другий — від API-сервера до будь-якого вузла, Podʼа чи Service через проксі API-сервера.
Звʼязок API-сервера з kubelet
Зʼєднання від API-сервера до kubelet використовуються для:
Отримання логів для Podʼів.
Приєднання (зазвичай через kubectl) до запущених Podʼів.
Забезпечення функціональності перенаправлення портів kubelet.
Ці зʼєднання завершуються на точці доступу HTTPS kubelet. Стандартно API-сервер не перевіряє сертифікат обслуговування kubelet, що робить зʼєднання вразливим до атаки "людина посередині" і небезпечним для використання через ненадійні та/або публічні мережі.
Щоб перевірити це зʼєднання, використовуйте прапорець --kubelet-certificate-authority, щоб надати API-серверу пакет кореневих сертифікатів для перевірки сертифіката обслуговування kubelet.
Якщо це неможливо, скористайтеся тунелюванням SSH між API-сервером та kubelet, якщо необхідно, щоб уникнути підключення через ненадійну або публічну мережу.
Зʼєднання від API-сервера до вузла, Podʼа чи Service типово використовують прості HTTP-зʼєднання і, отже, не автентифікуються й не шифруються. Їх можна використовувати через захищене зʼєднання HTTPS, підставивши https: перед назвою вузла, Podʼа чи Service в URL API, але вони не будуть перевіряти сертифікат, наданий точкою доступу HTTPS, та не надаватимуть облікові дані клієнта. Таким чином, хоча зʼєднання буде зашифрованим, воно не гарантує цілісності. Ці зʼєднання поки не є безпечними для використання через ненадійні або публічні мережі.
Тунелі SSH
Kubernetes підтримує тунелі SSH, щоб захистити канали звʼязку від панелі управління до вузлів. У цій конфігурації API-сервер ініціює тунель SSH до кожного вузла в кластері (підключаючись до SSH-сервера, який прослуховує порт 22) і передає весь трафік, призначений для kubelet, вузла, Podʼа чи Service, через тунель. Цей тунель гарантує, що трафік не виходить за межі мережі, в якій працюють вузли.
Примітка:
Тунелі SSH наразі застарілі, тому не варто їх використовувати, якщо ви не знаєте, що робите. Служба Konnectivity — це заміна для цього каналу звʼязку.
Служба Konnectivity
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.18
Як заміна тунелям SSH, служба Konnectivity надає проксі на рівні TCP для звʼязку панелі управління з кластером. Служба Konnectivity складається з двох частин: сервера Konnectivity в мережі панелі управління та агентів Konnectivity в мережі вузлів. Агенти Konnectivity ініціюють зʼєднання з сервером Konnectivity та підтримують мережеві підключення. Після ввімкнення служби Konnectivity весь трафік від панелі управління до вузлів проходить через ці зʼєднання.
Для налаштування служби Konnectivity у своєму кластері скористайтеся завданням служби Konnectivity.
🛇 Цей елемент посилається на сторонній проєкт або продукт, який не є частиною Kubernetes. Докладніше
Ваш кластер може потребувати додаткового програмного забезпечення на кожному вузлі; наприклад, ви можете також запускати systemd на вузлі Linux для контролю локальних компонентів.
Надбудови
Надбудови розширюють функціональність Kubernetes. Ось кілька важливих прикладів:
Для збереження логів контейнерів у централізованому сховищі логів.
Гнучкість архітектури
Kubernetes дозволяє гнучко розгортати ці компоненти та керувати ними. Архітектуру можна адаптувати до різних потреб, від невеликих середовищ розробки до великомасштабних промислових розгортань.
Для отримання більш детальної інформації про кожен компонент та різні способи налаштування кластерної архітектури, дивіться сторінку Архітектура кластера.
3.2 - Що таке Kubernetes?
Ця сторінка являє собою узагальнений огляд Kubernetes.
Kubernetes - це платформа з відкритим вихідним кодом для управління контейнеризованими робочими навантаженнями та супутніми службами. Її основні характеристики - кросплатформенність, розширюваність, успішне використання декларативної конфігурації та автоматизації. Вона має гігантську, швидкопрогресуючу екосистему.
Повернімось назад у часі та дізнаємось, завдяки чому Kubernetes став таким корисним.
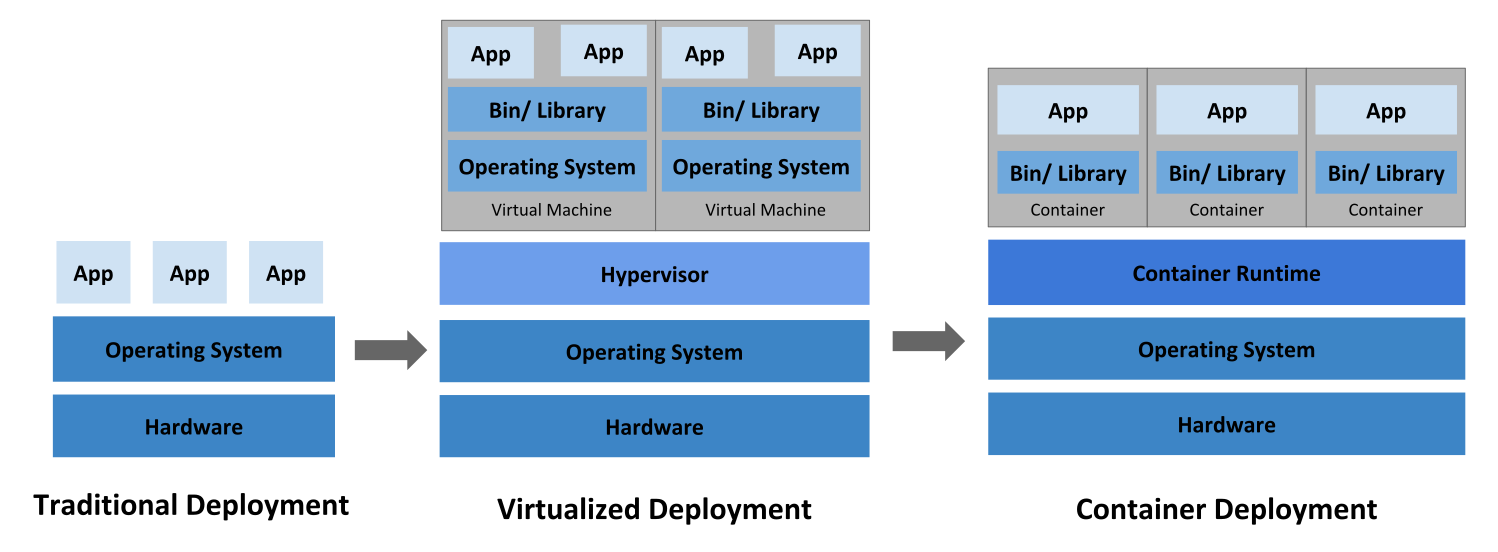
Ера традиційного розгортання: На початку організації запускали застосунки на фізичних серверах. Оскільки в такий спосіб не було можливості задати обмеження використання ресурсів, це спричиняло проблеми виділення та розподілення ресурсів на фізичних серверах. Наприклад: якщо багато застосунків було запущено на фізичному сервері, могли траплятись випадки, коли один застосунок забирав собі найбільше ресурсів, внаслідок чого інші програми просто не справлялись з обов'язками. Рішенням може бути запуск кожного застосунку на окремому фізичному сервері. Але такий підхід погано масштабується, оскільки ресурси не повністю використовуються; на додачу, це дорого, оскільки організаціям потрібно опікуватись багатьма фізичними серверами.
Ера віртуалізованого розгортання: Як рішення - була представлена віртуалізація. Вона дозволяє запускати численні віртуальні машини (Virtual Machines або VMs) на одному фізичному ЦПУ сервера. Віртуалізація дозволила застосункам бути ізольованими у межах віртуальних машин та забезпечувала безпеку, оскільки інформація застосунку на одній VM не була доступна застосунку на іншій VM.
Віртуалізація забезпечує краще використання ресурсів на фізичному сервері та кращу масштабованість, оскільки дозволяє легко додавати та оновлювати застосунки, зменшує витрати на фізичне обладнання тощо. З віртуалізацією ви можете представити ресурси у вигляді одноразових віртуальних машин.
Кожна VM є повноцінною машиною з усіма компонентами, включно з власною операційною системою, що запущені поверх віртуалізованого апаратного забезпечення.
Ера розгортання контейнерів: Контейнери схожі на VM, але мають спрощений варіант ізоляції і використовують спільну операційну систему для усіх застосунків. Саме тому контейнери вважаються "легкими", в порівнянні з віртуалками. Подібно до VM, контейнер має власну файлову систему, ЦПУ, пам'ять, простір процесів тощо. Оскільки контейнери вивільнені від підпорядкованої інфраструктури, їх можна легко переміщати між хмарними провайдерами чи дистрибутивами операційних систем.
Контейнери стали популярними, бо надавали додаткові переваги, такі як:
Створення та розгортання застосунків за методологією Agile: спрощене та більш ефективне створення образів контейнерів у порівнянні до використання образів віртуальних машин.
Безперервна розробка, інтеграція та розгортання: забезпечення надійних та безперервних збирань образів контейнерів, їх швидке розгортання та легкі відкатування (за рахунок незмінності образів).
Розподіл відповідальності команд розробки та експлуатації: створення образів контейнерів застосунків під час збирання/релізу на противагу часу розгортання, і як наслідок, вивільнення застосунків із інфраструктури.
Спостереження не лише за інформацією та метриками на рівні операційної системи, але й за станом застосунку та іншими сигналами.
Однорідність середовища для розробки, тестування та робочого навантаження: запускається так само як на робочому комп'ютері, так і у хмарного провайдера.
ОС та хмарна кросплатформність: запускається на Ubuntu, RHEL, CoreOS, у власному дата-центрі, у Google Kubernetes Engine і взагалі будь-де.
Керування орієнтоване на застосунки: підвищення рівня абстракції від запуску операційної системи у віртуальному апаратному забезпеченні до запуску застосунку в операційній системі, використовуючи логічні ресурси.
Нещільно зв'язані, розподілені, еластичні, вивільнені мікросервіси: застосунки розбиваються на менші, незалежні частини для динамічного розгортання та управління, на відміну від монолітної архітектури, що працює на одній великій виділеній машині.
Використання ресурсів: висока ефективність та щільність.
Чому вам потрібен Kubernetes і що він може робити
Контейнери - це прекрасний спосіб упакувати та запустити ваші застосунки. У прод оточенні вам потрібно керувати контейнерами, в яких працюють застосунки, і стежити, щоб не було простою. Наприклад, якщо один контейнер припиняє роботу, інший має бути запущений йому на заміну. Чи не легше було б, якби цим керувала сама система?
Ось де Kubernetes приходить на допомогу! Kubernetes надає вам каркас для еластичного запуску розподілених систем. Він опікується масштабуванням та аварійним відновленням вашого застосунку, пропонує шаблони розгортань тощо. Наприклад, Kubernetes дозволяє легко створювати розгортання за стратегією canary у вашій системі.
Kubernetes надає вам:
Виявлення сервісів та балансування навантаження
Kubernetes може надавати доступ до контейнера, використовуючи DNS-ім'я або його власну IP-адресу. Якщо контейнер зазнає завеликого мережевого навантаження, Kubernetes здатний збалансувати та розподілити його таким чином, щоб якість обслуговування залишалась стабільною.
Оркестрація сховища інформації
Kubernetes дозволяє вам автоматично монтувати системи збереження інформації на ваш вибір: локальні сховища, рішення від хмарних провайдерів тощо.
Автоматичне розгортання та відкатування
За допомогою Kubernetes ви можете описати бажаний стан контейнерів, що розгортаються, і він регульовано простежить за виконанням цього стану. Наприклад, ви можете автоматизувати в Kubernetes процеси створення нових контейнерів для розгортання, видалення існуючих контейнерів і передачу їхніх ресурсів на новостворені контейнери.
Автоматичне розміщення задач
Ви надаєте Kubernetes кластер для запуску контейнерізованих задач і вказуєте, скільки ресурсів ЦПУ та пам'яті (RAM) необхідно для роботи кожного контейнера. Kubernetes розподіляє контейнери по вузлах кластера для максимально ефективного використання ресурсів.
Самозцілення
Kubernetes перезапускає контейнери, що відмовили; заміняє контейнери; зупиняє роботу контейнерів, що не відповідають на задану користувачем перевірку стану, і не повідомляє про них клієнтам, допоки ці контейнери не будуть у стані робочої готовності.
Управління секретами та конфігурацією
Kubernetes дозволяє вам зберігати та керувати чутливою інформацією, такою як паролі, OAuth токени та SSH ключі. Ви можете розгортати та оновлювати секрети та конфігурацію без перезбирання образів ваших контейнерів, не розкриваючи секрети в конфігурацію стека.
Чим не є Kubernetes
Kubernetes не є комплексною системою PaaS (Платформа як послуга) у традиційному розумінні. Оскільки Kubernetes оперує швидше на рівні контейнерів, аніж на рівні апаратного забезпечення, деяка загальнозастосована функціональність і справді є спільною з PaaS, як-от розгортання, масштабування, розподіл навантаження, логування і моніторинг. Водночас Kubernetes не є монолітним, а вищезазначені особливості підключаються і є опціональними. Kubernetes надає будівельні блоки для створення платформ для розробників, але залишає за користувачем право вибору у важливих питаннях.
Kubernetes:
Не обмежує типи застосунків, що підтримуються. Kubernetes намагається підтримувати найрізноманітніші типи навантажень, включно із застосунками зі станом (stateful) та без стану (stateless), навантаження по обробці даних тощо. Якщо ваш застосунок можна контейнеризувати, він чудово запуститься під Kubernetes.
Не розгортає застосунки з вихідного коду та не збирає ваші застосунки. Процеси безперервної інтеграції, доставки та розгортання (CI/CD) визначаються на рівні організації, та в залежності від технічних вимог.
Не надає сервіси на рівні застосунків як вбудовані: програмне забезпечення проміжного рівня (наприклад, шина передачі повідомлень), фреймворки обробки даних (наприклад, Spark), бази даних (наприклад, MySQL), кеш, некластерні системи збереження інформації (наприклад, Ceph). Ці компоненти можуть бути запущені у Kubernetes та/або бути доступними для застосунків за допомогою спеціальних механізмів, наприклад Open Service Broker.
Не нав'язує використання інструментів для логування, моніторингу та сповіщень, натомість надає певні інтеграційні рішення як прототипи, та механізми зі збирання та експорту метрик.
Не надає та не змушує використовувати якусь конфігураційну мову/систему (як наприклад Jsonnet), натомість надає можливість використовувати API, що може бути використаний довільними формами декларативних специфікацій.
Не надає і не запроваджує жодних систем машинної конфігурації, підтримки, управління або самозцілення.
На додачу, Kubernetes - не просто система оркестрації. Власне кажучи, вона усуває потребу оркестрації як такої. Технічне визначення оркестрації - це запуск визначених процесів: спочатку A, за ним B, потім C. На противагу, Kubernetes складається з певної множини незалежних, складних процесів контролерів, що безперервно опрацьовують стан у напрямку, що заданий бажаною конфігурацією. Неважливо, як ви дістанетесь з пункту A до пункту C. Централізоване управління також не є вимогою. Все це виливається в систему, яку легко використовувати, яка є потужною, надійною, стійкою та здатною до легкого розширення.
Обʼєкти Kubernetes є постійними сутностями в системі Kubernetes. Kubernetes використовує ці сутності для подання стану вашого кластера. Дізнайтеся про модель обʼєктів Kubernetes та про те, як працювати з цими обʼєктами.
Ця сторінка пояснює, як обʼєкти Kubernetes подаються в API Kubernetes, та як ви можете описати їх у форматі .yaml.
Розуміння обʼєктів Kubernetes
Обʼєкти Kubernetes є постійними сутностями в системі Kubernetes. Kubernetes використовує ці сутності для подання стану вашого кластера. Зокрема, вони можуть описувати:
Які контейнеризовані застосунки працюють (і на яких вузлах)
Ресурси, доступні для цих застосунків
Політики щодо того, як ці застосунки поводяться, такі як політики перезапуску, оновлення та стійкості до відмов
Обʼєкт Kubernetes є "записом про наміри" — після створення обʼєкта система Kubernetes постійно працюватиме, щоб переконатися, що обʼєкт існує. Створюючи обʼєкт, ви фактично повідомляєте системі Kubernetes ваші побажання щодо того, як має виглядати робоче навантаження вашого кластера; це бажаний стан вашого кластера.
Для роботи з обʼєктами Kubernetes — чи то для створення, зміни чи видалення — вам потрібно використовувати API Kubernetes. Наприклад, коли ви використовуєте інтерфейс командного рядка kubectl, CLI виконує необхідні виклики API Kubernetes за вас. Ви також можете використовувати API Kubernetes безпосередньо у ваших власних програмах за допомогою однієї з клієнтських бібліотек.
Специфікація та стан обʼєкта
Майже кожен обʼєкт Kubernetes містить два вкладених поля обʼєкта, які керують конфігурацією обʼєкта: spec та status обʼєкта. Для обʼєктів, які мають spec, вам потрібно встановити його під час створення обʼєкта, надаючи опис характеристик, які ви хочете, щоб ресурс мав: його бажаний стан.
status описує поточний стан обʼєкта, який надається та оновлюється системою Kubernetes та її компонентами. Панель управління Kubernetes постійно та активно керує фактичним станом кожного обʼєкта, щоб він відповідав бажаному стану, який ви вказали.
Наприклад: у Kubernetes Deployment є обʼєктом, який може представляти застосунок, який працює на вашому кластері. При створенні Deployment ви можете встановити spec Deployment, щоб вказати, що ви хочете, щоб працювало три репліки застосунку. Система Kubernetes читає spec Deployment та запускає три екземпляри вашого застосунку, оновлюючи status відповідно до вашого spec. Якщо один із цих екземплярів зазнає збою (зміна стану), система Kubernetes реагує на відмінність між spec та status, вносячи виправлення: у цьому випадку запускаючи екземпляр на заміну.
З докладнішою інформацією про spec, status та metadata обʼєктів Kubernetes звертайтесь до Kubernetes API Conventions.
Опис обʼєктів Kubernetes
Коли ви створюєте обʼєкт Kubernetes, ви повинні визначити spec обʼєкта, який описує бажаний стан обʼєкта, а також деякі основні відомості про обʼєкт, наприклад його назву (name). Коли ви використовуєте API Kubernetes для створення обʼєкта, чи безпосередньо, чи за допомогою kubectl, цей запит до API має містити ці відомості у вигляді JSON в тілі запиту. Найчастіше інформація про обʼєкт подається kubectl у вигляді файлу, який називається маніфестом. За домовленістю, маніфести обʼєктів Kubernetes подаються у форматі YAML (ви також можете використовувати JSON). Інструменти, такі як kubectl, перетворюють інформацію з маніфесту у JSON або інший підтримуваний формат серіалізації, надсилаючи HTTP-запити до API.
Ось приклад маніфесту, який містить обовʼязкові поля обʼєкта та його spec для Kubernetes Deployment:
apiVersion:apps/v1kind:Deploymentmetadata:name:nginx-deploymentspec:selector:matchLabels:app:nginxreplicas:2# tells deployment to run 2 pods matching the templatetemplate:metadata:labels:app:nginxspec:containers:- name:nginximage:nginx:1.14.2ports:- containerPort:80
Один зі способів створення Deployment за допомогою маніфесту, подібного до показаного вище, — використання команди kubectl apply в інтерфейсі командного рядка kubectl, передаючи файл .yaml як аргумент. Ось приклад:
В маніфесті (файл YAML або JSON) обʼєкта Kubernetes, який ви хочете створити, ви повинні вказати значення для таких полів:
apiVersion — версія API Kubernetes, яку ви використовуєте для створення обʼєкта
kind — тип обʼєкта, який ви хочете створити
metadata — дані, які допомагають унікально ідентифікувати обʼєкт, включаючи рядок name, UID та, необовʼязково, namespace
spec — опис бажаного стану обʼєкта
Точний формат spec обʼєкта є різним для кожного типу обʼєкта в Kubernetes та містить вкладені поля, що притаманні конкретному типу обʼєкта. Довідник API Kubernetes може допомогти знайти формат spec для всіх типів обʼєктів, які ви можете створити за допомогою Kubernetes.
Наприклад, подивіться на поле spec для обʼєкта Pod. Для кожного Podʼа поле .spec описує Pod та його бажаний стан (наприклад, назву образу контейнера для кожного контейнера всередині цього Podʼа). Інший приклад специфікації обʼєкта — поле spec для обʼєкта StatefulSet. Для StatefulSet поле .spec описує StatefulSet та його бажаний стан. У .spec StatefulSet є шаблон для обʼєктів Pod. Цей шаблон описує Podʼи, які контролер StatefulSet створить, щоб задовольнити специфікацію StatefulSet. Різні типи обʼєктів Kubernetes можуть мати різні .status; дивіться довідник API Kubernetes для отримання відомостей про структуру поля .status та його вміст для кожного типу обʼєкта.
Починаючи з Kubernetes v1.25, API-сервер надає перевірку полів на стороні сервера, яка виявляє невідомі та дубльовані поля в обʼєкті. Це надає всю функціональність kubectl --validate на стороні сервера.
kubectl використовує прапорець --validate для встановлення рівня перевірки полів маніфесту. Його значенням може бути ignore, warn та strict, також можна вказати true (еквівалент strict) та false (еквівалент ignore). Типове значення перевірки для kubectl — --validate=true.
Strict
Сувора перевірка, повертає збій під час виявлення помилок.
Warn
Перевірка виконується, але виявлення помилок призводить до виведення попереджень, а не збою.
Ignore
Перевірка на стороні сервера не виконується.
Якщо kubectl не може підʼєднатися до API-сервера, який підтримує перевірку полів, він використовує перевірку на стороні клієнта. Kubernetes v1.27 та пізніші версії завжди пропонуватимуть перевірку полів; версії до v1.27, скоріш за все — ні. Якщо версія Kubernetes на вашому кластері старіша за v1.27, звіртесь з документацією до вашої версії Kubernetes.
Що далі
Якщо ви тільки починаєте свій шлях в Kubernetes, дізнайтесь більше про:
Щоб глибше ознайомитися з обʼєктами в Kubernetes, прочитайте інші сторінки цього розділу:
3.3.1 - Управління обʼєктами Kubernetes
Інструмент командного рядка kubectl підтримує кілька різних способів створення та управління обʼєктами Kubernetes. Цей документ надає огляд різних підходів. Для отримання деталей щодо управління обʼєктами за допомогою Kubectl читайте Книгу Kubectl.
Техніки управління
Попередження:
Обʼєкт Kubernetes повинен управлятися лише з використанням однієї техніки. Змішування різних технік для того самого обʼєкта призводить до невизначеної поведінки.
Техніка управління
Діє на
Рекомендоване середовище
Підтримувані автори змін
Крива навчання
Імперативні команди
Живі обʼєкти
Проєкти розробки
1+
Найлегша
Імперативна конфігурація обʼєктів
Окремі файли
Промислові проєкти
1
Середня
Декларативна конфігурація обʼєктів
Теки файлів
Промислові проєкти
1+
Найскладніша
Імперативні команди
Під час використання імперативних команд користувач працює безпосередньо з живими обʼєктами в кластері. Користувач надає операції команді kubectl у вигляді аргументів чи прапорців.
Це рекомендований спосіб початку роботи або виконання одноразового завдання в кластері. Оскільки цей метод працює безпосередньо з живими обʼєктами, він не зберігає історії попередніх конфігурацій.
Команди вимагають лише одного кроку для внесення змін до кластера.
Недоліки порівняно із конфігуруванням обʼєктів:
Команди не інтегруються з процесами перегляду змін.
Команди не надають журналу аудиту, повʼязаного зі змінами.
Команди не надають джерела записів, окрім самих живих обʼєктів.
Команди не надають шаблону для створення нових обʼєктів.
Імперативне конфігурування обʼєктів
В імперативній конфігурації обʼєктів команда kubectl вказує операцію (create, replace тощо), необовʼязкові прапорці та принаймні одне імʼя файлу. Зазначений файл повинен містити повне визначення обʼєкта у форматі YAML або JSON.
Див. API-довідник для отримання докладніших відомостей щодо визначення обʼєктів.
Попередження:
Імперативна команда replace замінює поточну специфікацію на нову, відкидаючи всі зміни обʼєкта, яких немає у файлі конфігурації. Цей підхід не повинен використовуватися із типами ресурсів, специфікації яких оновлюються незалежно від файлу конфігурації. Наприклад, у Services типу LoadBalancer поле externalIPs оновлюється кластером незалежно від файлу конфігурації.
Приклади
Створити обʼєкти, визначені у файлі конфігурації:
kubectl create -f nginx.yaml
Видалити обʼєкти, визначені у двох файлах конфігурації:
kubectl delete -f nginx.yaml -f redis.yaml
Оновити обʼєкти, визначені у файлі конфігурації, перезаписавши живу конфігурацію:
kubectl replace -f nginx.yaml
Компроміси
Переваги порівняно з імперативними командами:
Конфігурація обʼєктів може зберігатися у системі контролю версій, такій як Git.
Конфігурація обʼєктів може інтегруватися з процесами, такими як перегляд змін перед надсиланням (push) та журнали аудиту.
Конфігурація обʼєктів надає шаблон для створення нових обʼєктів.
Недоліки порівняно з імперативними командами:
Конфігурація обʼєктів потребує базового розуміння схеми обʼєкта.
Конфігурація обʼєктів потребує додаткового кроку у вигляді написання файлу YAML.
Переваги порівняно із декларативною конфігурацією обʼєктів:
Поведінка імперативної конфігурації обʼєктів простіша та її легше зрозуміти.
Станом на версію Kubernetes 1.5 імперативна конфігурація обʼєктів є більш зрілою.
Недоліки порівняно із декларативною конфігурацією обʼєктів:
Імперативна конфігурація обʼєктів працює краще з файлами, а не з теками.
Оновлення живих обʼєктів мають відображатися у файлах конфігурації, інакше вони будуть втрачені під час наступної заміни.
Декларативна конфігурація обʼєктів
Під час використання декларативної конфігурації обʼєктів користувач працює з конфігураційними файлами обʼєктів, збереженими локально, проте користувач не визначає операції, які слід виконати над файлами. Операції створення, оновлення та видалення автоматично визначаються для кожного обʼєкта за допомогою kubectl. Це дозволяє працювати з теками, де для різних обʼєктів можуть бути потрібні різні операції.
Примітка:
Декларативна конфігурація обʼєктів зберігає зміни, внесені іншими авторами, навіть якщо зміни не зливаються назад у файл конфігурації обʼєкта. Це можливо за допомогою використання операції API patch для запису тільки виявлених відмінностей, замість використання операції API replace для заміни всього файлу конфігурації обʼєкта.
Приклади
Обробити всі файли конфігурації обʼєктів у теці configs та створити або внести патчі до живих обʼєктів. Спочатку ви можете використовувати diff, щоб побачити, які зміни будуть внесені, а потім застосувати їх:
Переваги порівняно з імперативною конфігурацією обʼєктів:
Зміни, внесені безпосередньо в живі обʼєкти, зберігаються, навіть якщо вони не зливаються назад у файли конфігурації.
Декларативна конфігурація обʼєктів краще підтримує роботу з теками та автоматично визначає типи операцій (створення, патч, видалення) для кожного обʼєкта.
Недоліки порівняно з імперативною конфігурацією обʼєктів:
Декларативну конфігурацію обʼєктів важче налагоджувати, а її результати важче зрозуміти, коли вони неочікувані.
Часткові оновлення за допомогою diffs створюють складні операції злиття та накладання патчів.
Кожен обʼєкт у вашому кластері має Назву, яка є унікальною для цього типу ресурсу. Кожен обʼєкт Kubernetes також має UID, який є унікальним в усьому вашому кластері.
Наприклад, ви можете мати лише один обʼєкт Pod із назвою myapp-1234 в одному й тому самому просторі імен, а також ви можете мати один обʼєкт Pod та один Deployment із назвами myapp-1234 кожен.
Наданий клієнтом рядок, який посилається на обʼєкт в URL ресурсу, наприклад /api/v1/pods/some-name.
Водночас лише один обʼєкт певного виду (kind) може мати певну назву. Проте якщо ви видалите обʼєкт, ви можете створити новий обʼєкт з такою самою назвою.
Назви повинні бути унікальними між усіма версіями API того самого ресурсу.
Kubernetes унікально ідентифікує обʼєкти за допомогою комбінації чотирьох атрибутів:
Група API (наприклад, apps)
Тип ресурсу (наприклад, deployments)
Простір імен (для ресурсів із просторами імен)
Назва
Хоча ви можете отримати доступ до ресурсу через різні версії API (наприклад, v1 або v1beta1), версія є просто іншим представленням того самого базового обʼєкта. Оскільки версія не є частиною унікальної ідентифікації, ви не можете створити два обʼєкти з однаковою назвою та типом ресурсу в одному просторі імен, використовуючи різні версії API.
Примітка:
У випадках, коли обʼєкти представляють фізичний обʼєкт, наприклад, Node, що представляє фізичний хост, коли хост створюється заново з тією самою назвою без видалення та повторного створення Node, Kubernetes розглядає новий хост як старий, що може призвести до неузгодженостей.
Сервер може згенерувати назву, якщо в запиті на створення ресурсу замість name вказати generateName. Коли використовується generateName, надане значення використовується як префікс назви, до якого сервер додає згенерований суфікс. Навіть якщо назву згенеровано, вона може конфліктувати з наявними назвами, що призведе до відповіді HTTP 409. Це стало набагато менш імовірним в Kubernetes v1.31 і пізніших версіях, оскільки сервер зробить до 8 спроб згенерувати унікальну назву перед тим, як повернути відповідь HTTP 409.
Нижче наведено чотири типи обмежень на назви ресурсів, які часто використовуються.
Назви DNS-піддоменів
Більшість типів ресурсів потребують назви, яку можна використовувати як DNS-піддомен згідно з RFC 1123. Це означає, що назва повинна:
містити не більше 253 символів
містити лише буквено-цифрові символи, '-' чи '.' в нижньому регістрі
починатися буквено-цифровим символом
закінчуватися буквено-цифровим символом
Назви міток RFC 1123
Деякі типи ресурсів вимагають, щоб їх назви відповідали стандарту міток DNS, як визначено в RFC 1123. Це означає, що назва повинна:
містити не більше 63 символів
містити лише буквено-цифрові символи чи '-' в нижньому регістрі
починатися алфавітним символом
закінчуватися буквено-цифровим символом
Примітка:
Коли увімкнено функціональну можливість RelaxedServiceNameValidation, назви обʼєктів Service можуть починатися з цифри.
Назви міток RFC 1035
Деякі типи ресурсів вимагають, щоб їх назви відповідали стандарту міток DNS, як визначено в RFC 1035. Це означає, що назва повинна:
містити не більше 63 символів
містити лише буквено-цифрові символи чи '-' в нижньому регістрі
починатися алфавітним символом
закінчуватися буквено-цифровим символом
Примітка:
Хоча RFC 1123 технічно дозволяє міткам починатися з цифри, поточна реалізація Kubernetes вимагає, щоб мітки як RFC 1035, так і RFC 1123 починалися з літери. Винятком є увімкнення функціональної можливості RelaxedServiceNameValidation для обʼєктів Service, що дозволяє назвам Service починатися з цифри.
Назви сегментів шляху
Деякі типи ресурсів вимагають, щоб їх назви можна було безпечно кодувати як сегмент шляху. Іншими словами, назва не може бути "." або "..", і вона не може містити "/" або "%".
Ось приклад маніфесту для Pod із назвою nginx-demo.
Деякі типи ресурсів мають додаткові обмеження на їх назви.
UID
Рядок, створений системами Kubernetes для унікальної ідентифікації обʼєктів.
Кожен обʼєкт, створений протягом усього життя кластера Kubernetes, має унікальний UID. Він призначений для розрізнення історичних екземплярів схожих сутностей.
UID Kubernetes — це універсальні унікальні ідентифікатори (також відомі як UUID). UUID стандартизовані згідно з ISO/IEC 9834-8 та ITU-T X.667.
У Kubernetes деякі обʼєкти є власниками інших обʼєктів. Наприклад, ReplicaSet є власником групи Podʼів. Ці підлеглі обʼєкти є залежними від свого власника.
Власність відрізняється від механізму міток та селекторів, який також використовують деякі ресурси. Наприклад, розгляньте Service, який створює обʼєкти EndpointSlice. Service використовує мітки, щоб панель управління могла визначити, які обʼєкти EndpointSlice використовуються для цього Service. Крім міток, кожен EndpointSlice, керований від імені Service, має посилання на власника. Посилання на власника допомагають різним частинам Kubernetes уникати втручання в обʼєкти, якими вони не керують.
Посилання на власника в специфікаціях обʼєктів
Залежні обʼєкти мають поле metadata.ownerReferences, яке містить посилання на їх власника. Дійсне посилання на власника складається з назви обʼєкта та UID в межах того ж простору імен, що й залежний обʼєкт. Kubernetes автоматично встановлює значення цього поля для обʼєктів, які є залежностями інших обʼєктів, таких як ReplicaSets, DaemonSets, Deployments, Jobs та CronJobs, та ReplicationControllers. Ви також можете налаштувати ці звʼязки вручну, змінивши значення цього поля. Однак зазвичай цього не потрібно робити, і можна дозволити Kubernetes автоматично керувати цими звʼязками.
Залежні обʼєкти також мають поле ownerReferences.blockOwnerDeletion, яке має булеве значення і контролює, чи можуть певні залежні обʼєкти блокувати збір сміття, що видаляє їх власника. Kubernetes автоматично встановлює це поле в true, якщо контролер (наприклад, контролер Deployment) встановлює значення поля metadata.ownerReferences. Ви також можете встановити значення поля blockOwnerDeletion вручну, щоб контролювати, які залежні обʼєкти блокують збір сміття.
Контролер допуску Kubernetes контролює доступ користувачів до зміни цього поля для залежних ресурсів на основі прав видалення власника. Цей контроль перешкоджає несанкціонованим користувачам затримувати видалення обʼєкта-власника.
Примітка:
Посилання на власника з іншого простору імен заборонені за задумом. Залежні обʼєкти в межах простору імен можуть вказувати власників рівня кластера або рівня простору імен. Власник рівня простору імен повинен існувати в тому самому просторі імен, що й залежний обʼєкт. Якщо це не так, посилання на власника вважається відсутнім, і залежний обʼєкт підлягає видаленню після перевірки відсутності всіх власників.
Залежні обʼєкти рівня кластера можуть вказувати тільки власників рівня кластера. У v1.20+, якщо залежний обʼєкт рівня кластера вказує як власника тип у межах простору імен, вважається, що він має нерозвʼязне посилання на власника, і його не можна прибрати збором сміття.
У v1.20+, якщо збирач сміття виявляє недійсний ownerReference між просторами імен або залежний обʼєкт рівня кластера з ownerReference, що посилається на тип у межах простору імен, повідомляється про попереджувальну подію з причиною OwnerRefInvalidNamespace та involvedObject недійсного залежного елемента. Ви можете перевірити наявність такого роду подій (Event), запустивши kubectl get events -A --field-selector=reason=OwnerRefInvalidNamespace.
Власність та завершувачі
Коли ви наказуєте Kubernetes видалити ресурс, API-сервер дозволяє контролеру, що керує ресурсом, обробити будь-які правила завершувача для ресурсу. Завершувачі запобігають випадковому видаленню ресурсів, які вашому кластеру можуть ще бути потрібні для коректної роботи. Наприклад, якщо ви намагаєтеся видалити PersistentVolume, який все ще використовується Podʼом, видалення не відбувається негайно, оскільки PersistentVolume має завершувач kubernetes.io/pv-protection. Замість цього том залишається в стані Terminating до тих пір, поки Kubernetes не очистить завершувач, що відбувається тільки після того, як PersistentVolume більше не привʼязаний до Podʼа.
Kubernetes також додає завершувачі до ресурсу-власника, коли ви використовуєте або каскадне видалення на передньому плані або каскадне видалення сиріт. Під час видалення на передньому плані додається завершувач foreground, так що контролер повинен видалити залежні ресурси, які також мають ownerReferences.blockOwnerDeletion=true, перш ніж він видалить власника. Якщо ви вказуєте політику видалення покинутих ресурсів (сиріт), Kubernetes додає завершувач orphan, так що контролер ігнорує залежні ресурси після того, як він видаляє обʼєкт-власника.
Ви можете візуалізувати обʼєкти Kubernetes і керувати ними не лише за допомогою kubectl і панелі керування (dashboard), а й за допомогою інших інструментів. Загальний набір міток дозволяє інструментам працювати між собою, описуючи обʼєкти спільним чином, який можуть розуміти всі інструменти.
Крім підтримки інструментів, рекомендовані мітки описують застосунки так, що до них можна робити запити.
Метадані організовані навколо концепції застосунку. Kubernetes не є платформою як сервіс (PaaS) і не має та не навʼязує формального поняття застосунку. Замість цього застосунки є неформальними та описуються метаданими. Визначення того, що включає застосунок, є гнучким.
Примітка:
Це рекомендовані мітки. Вони полегшують управління застосунками, але не обовʼязкові для будь-яких основних інструментів.
Спільні мітки та анотації мають спільний префікс: app.kubernetes.io. Мітки без префіксу є приватними для користувачів. Спільний префікс забезпечує, що спільні мітки не перешкоджають роботі власних міток користувачів.
Мітки
Щоб повною мірою скористатися цими мітками, їх слід застосовувати до кожного обʼєкта ресурсу.
Ключ
Опис
Приклад
Тип
app.kubernetes.io/name
Назва застосунку
mysql
рядок
app.kubernetes.io/instance
Унікальна назва, що ідентифікує екземпляр застосунку
mysql-abcxyz
рядок
app.kubernetes.io/version
Поточна версія застосунку (наприклад, SemVer 1.0, хеш ревізії тощо)
5.7.21
рядок
app.kubernetes.io/component
Компонент всередині архітектури
database
рядок
app.kubernetes.io/part-of
Назва застосунку вищого рівня, частиною якого є цей застосунок
wordpress
рядок
app.kubernetes.io/managed-by
Інструмент, який використовується для управління роботою застосунку
Helm
рядок
Щоб проілюструвати ці мітки в дії, розгляньте такий обʼєкт StatefulSet:
# Це уривокapiVersion:apps/v1kind:StatefulSetmetadata:labels:app.kubernetes.io/name:mysqlapp.kubernetes.io/instance:mysql-abcxyzapp.kubernetes.io/version:"5.7.21"app.kubernetes.io/component:databaseapp.kubernetes.io/part-of:wordpressapp.kubernetes.io/managed-by:Helm
Застосунки та екземпляри застосунків
Застосунок можна встановити один або декілька разів у кластер Kubernetes і, у деяких випадках, у той самий простір імен. Наприклад, WordPress можна встановити більше одного разу, де різні вебсайти є різними екземплярами WordPress.
Назва застосунку та назва екземпляра записуються окремо. Наприклад, у WordPress є app.kubernetes.io/name — wordpress, тоді як назва екземпляра представлена як app.kubernetes.io/instance зі значенням wordpress-abcxyz. Це дозволяє ідентифікувати застосунок та його екземпляр. Кожен екземпляр застосунку повинен мати унікальну назву.
Приклади
Щоб проілюструвати різні способи використання цих міток, наведено приклади різної складності.
Простий Stateless Service
Розгляньте випадок простого Stateless Service, розгорнутого за допомогою обʼєктів Deployment та Service. Наведені нижче два уривки представляють, як можуть бути використані мітки у їх найпростішій формі.
Deployment використовується для нагляду за Podʼами, які виконують сам застосунок.
Розгляньмо трохи складніший застосунок: вебзастосунок (WordPress) із базою даних (MySQL), встановлений за допомогою Helm. Наведені нижче уривки ілюструють початок обʼєктів, які використовуються для розгортання цього застосунку.
Початок цього Deployment використовується для WordPress:
Зверніть увагу, що StatefulSet та Service для MySQL містять інформацію як про MySQL, так і про WordPress, ширший застосунок.
3.3.5 - Версії зберігання
API-сервер Kubernetes зберігає обʼєкти, покладаючись на etcd-сумісне сховище (часто це сам etcd). Кожен обʼєкт серіалізується за допомогою певної версії типу API; наприклад, представлення v1 ConfigMap. Kubernetes використовує термін версія зберігання для опису того, як зберігається обʼєкт у вашому кластері.
API Kubernetes також покладається на автоматичне перетворення; наприклад, якщо у вас є HorizontalPodAutoscaler, то ви можете взаємодіяти з цим HorizontalPodAutoscaler, використовуючи будь-яку комбінацію версій v1 та v2 API HorizontalPodAutoscaler. Kubernetes відповідає за перетворення кожного API-запиту, щоб клієнти не бачили, яка версія насправді серіалізується.
Для адміністраторів кластерів версія зберігання обʼєкта є важливим поняттям для розуміння, оскільки саме вона звʼязує представлення обʼєкта у API з фактичним кодуванням у бекенді сховища. Це може бути важливим у разі, коли певне бінарне кодування обʼєкта має значення, наприклад для шифрування в стані спокою або визнання API застарілим.
Той самий API може мати кілька версій зберігання, які API-сервер може перетворювати на схему обʼєкта. Один обʼєкт, що є частиною цього ресурсу, повинен мати лише одну версію зберігання в будь-який момент часу. Це означає, що API-сервер знає бінарне кодування обʼєктів і може виконувати динамічне перетворення між всіма збереженими версіями до представлення обʼєкта у API.
Версія обʼєкта є повністю відокремленою від версії зберігання. Наприклад, API-обʼєкти v1alpha1 та v1beta1 для того самого ресурсу будуть закодовані однаково в сховищі, доки версія зберігання не буде оновлена між двома обʼєктами.
Відповідність версій зберігання ресурсам
Кожен ресурс матиме 1 активну версію зберігання в будь-який момент часу, тобто будь-який запис до обʼєкта збереже обʼєкт у цій версії зберігання. Однак версію зберігання можна оновлювати, що дозволяє зберігати обʼєкти в різних версіях. Один обʼєкт зберігатиметься лише в одній версії зберігання в будь-який момент часу.
Зчитування з API-сервера конвертуватиме збережені дані в API-представлення обʼєкта. Це дозволяє старим версіям зберігання зберігатися необмежений час, доки не відбудуться оновлення обʼєкта. З іншого боку, записи конвертуватимуть збережений обʼєкт у нове представлення після оновлення.
Версії зберігання для власних ресурсів
Власні ресурси визначаються динамічно, тому їхні версії зберігання відрізняються від версій вбудованих типів Kubernetes. Вбудовані обʼєкти загалом мають своє кодування сховища, визначене окремо від їхніх типів API, де збережений обʼєкт діє як центральний елемент, а конкретна версія ресурсу не має значення, окрім того, що це поле у схемі обʼєкта.
Однак для власних ресурсів певну версію ресурсу необхідно встановити як версію зберігання. Схема, визначена цією конкретною версією власного ресурсу, буде використовуватися як кодування ресурсу на рівні сховища. Див. розширений набір функцій CRD для отримання детальнішої інформації про налаштування API та керування версіями.
Наприклад, див. це CustomResourceDefinition для crontabs:
apiVersion:apiextensions.k8s.io/v1kind:CustomResourceDefinitionmetadata:name:crontabs.example.comspec:group:example.com# перелік версій, що підтримуються цим CustomResourceDefinitionversions:- name:v1beta1# Кожна версія може бути увімкнена/вимкнена за допомогою прапорця Served.served:true# Одна і тільки одна версія повинна бути позначена як версія зберігання.storage:trueschema:openAPIV3Schema:type:objectproperties:host:type:stringport:type:string- name:v1served:truestorage:falseschema:openAPIV3Schema:type:objectproperties:host:type:stringport:type:stringtime:type:stringconversion:strategy:Nonescope:Namespacednames:plural:crontabssingular:crontabkind:CronTabshortNames:- ct
Визначення API v1beta1 використовується як версія зберігання, тобто будь-які оновлення або створення crontabs зберігатимуться разом зі схемою обʼєкта API v1beta1. У цьому випадку це фактично означатиме, що обʼєкт API v1 ніколи не зможе зберігати поле time, оскільки воно не є частиною визначення сховища. Ця схема використовується на рівні сховища як двійкове кодування самого обʼєкта. Спроба встановити дві версії як версію, що зберігається, одночасно вважається недійсною, оскільки це означатиме, що дві схеми даних вважатимуться дійсними способами зберігання обʼєктів одночасно.
Після зміни версії, яка використовується для зберігання, ця версія API буде використовуватися для зберігання будь-яких нових або оновлених CR. Спостереження за обʼєктом або його отримання лише конвертуватиме обʼєкт зі старої версії зберігання, не змінюючи його. Тільки оновлення або створення матиме ефект і використовуватиме щойно визначену версію зберігання.
Як версії зберігання впливають на шифрування в стані спокою
Існують інструменти для шифрування сховища в стані спокою, особливо для Secrets кластера. Це додає додатковий рівень захисту від витоку даних, оскільки фактично збережені дані в кластері зашифровані. Це означає, що API-сервер фактично розшифровує дані під час їх отримання зі сховища. API-сервер повинен мати ключ для цієї версії зберігання, щоб правильно декодувати обʼєкт.
Версія зберігання в цьому випадку — це більше, ніж просто двійкове кодування обʼєкта. Якщо те, що зберігається, можна якимось чином перетворити на обʼєкт API, його можна використовувати як версію зберігання.
Міграція на іншу версію зберігання
Кілька версій зберігання для одного ресурсу можуть створювати проблеми для адміністраторів кластера. Адміністратор кластера не може видаляти старі версії API для CRD, які можуть не підтримуватися, доки не переконається, що всі обʼєкти більше не використовують повʼязану з ним версію зберігання. Через велику кількість обʼєктів та непрозоре уявлення про те, які з них є новими, а які все ще підтримуються старими версіями зберігання, важко визначити, коли версію можна безпечно видалити. Якщо версію видалено передчасно, обʼєкт може взагалі не вдатися прочитати.
Ще одним важливим питанням є використання ключів шифрування, як визначено у розділі вище. Оскільки ресурс повинен активно використовуватися для оновлення версії зберігання, після ротації ключів як старий, так і новий ключ шифрування повинні залишатися у використанні, доки адміністратор не переконається, що всі обʼєкти були записані принаймні один раз. Це створює як ризики для безпеки, так і проблеми з зручністю використання, оскільки ключ не може бути повністю вилучений з використання до того часу.
Див. міграцію версій зберігання для прикладів того, як виконати міграцію, щоб переконатися, що всі обʼєкти використовують новішу версію зберігання без ручного втручання.
3.4 - Інструмент командного рядка kubectl
kubectl є основним інструментом командного рядка для взаємодії з кластером Kubernetes. Ця сторінка надає огляд kubectl та його ролі в екосистемі Kubernetes.
Kubernetes надає інструмент командного рядка для взаємодії з панеллю управління кластера Kubernetes за допомогою API Kubernetes.
Інструмент kubectl взаємодіє з вашим кластером через API Kubernetes. kubectl шукає файл налаштувань з назвою config у теці $HOME/.kube. Ви можете вказати інші файли kubeconfig, встановивши змінну середовища KUBECONFIG або використавши прапорець --kubeconfig.
Роль kubectl
kubectl є основним інструментом для створення, перегляду, оновлення та видалення обʼєктів Kubernetes. Він доповнює компоненти Kubernetes, які працюють у вашому кластері, та API Kubernetes, який реалізують ці компоненти. Незалежно від того, чи запускаєте ви kubectl з вашого ноутбука, чи з Podʼа всередині кластера, він надсилає запити до API-сервера. Інші клієнти, такі як клієнтські бібліотеки та вебпанелі, такі як Headlamp, також взаємодіють через той самий API.
Як працює kubectl
Інструмент kubectl підключається до API-сервера та автентифікується за допомогою відомостей про кластер, користувача та контекст, визначених у вашому файлі kubeconfig. Коли ви запускаєте kubectl ззовні кластера, він використовує файл kubeconfig для пошуку адреси API-сервера та облікових даних. Коли kubectl працює всередині Podʼа (наприклад, у CI/CD конвеєрі), він може використовувати автентифікацію всередині кластера на основі токена ServiceAccount, змонтованого в Podʼі.
Коли ви запускаєте команду, kubectl перетворює ваші наміри на один або кілька HTTP-запитів до API Kubernetes. API-сервер перевіряє кожен запит, застосовує його до стану кластера, збереженого в etcd, і повертає результат. Це означає, що кожна дія kubectl, чи то створення Deployment, чи читання логів, проходить тим самим шляхом через API.
Оскільки ваш kubeconfig може визначати кілька кластерів, користувачів і контекстів, ви можете використовувати kubectl для перемикання між кластерами без повторного налаштування середовища. Використовуйте kubectl config use-context, щоб змінити активний контекст.
Що можна робити з kubectl
Інструмент kubectl підтримує багато операцій, які можна умовно розділити на такі категорії:
Керування ресурсами — Створення, оновлення та видалення обʼєктів, таких як Podʼи, Deployments та Services. Використовуйте kubectl apply для декларативного керування за допомогою конфігураційних файлів.
Перевірка стану кластера — Перегляд списків та описів обʼєктів, подій та використання ресурсів.
Налагодження — Перегляд логів контейнерів, виконання команд всередині запущеного контейнера або перенаправлення портів до Podʼа.
Операції з кластером — Очищення вузлів для обслуговування, позначення вузлів як непридатних для планування, щоб запобігти появі нових навантажень, та керування конфігурацією кластера.
Скрипти та автоматизація — Форматування виводу у JSON, YAML або власні колонки за допомогою JSONPath для використання у скриптах та конвеєрах.
Для ознайомлення з синтаксисом, довідником команд та прикладами, дивіться довідку kubectl.
Декларативне vs імперативне керування
Для робочих навантажень у промисловому середовищі рекомендується використовувати декларативне керування обʼєктами за допомогою kubectl apply з конфігураційними файлами з контролем версій. Декларативне керування допомагає відстежувати зміни, співпрацювати та інтегруватися з GitOps-процесами. Імперативні команди (такі як kubectl create або kubectl run) корисні для розробки та експериментів, але їх важче відтворювати та перевіряти.
Розширення kubectl за допомогою втулків
Ви можете розширювати kubectl за допомогою втулків, які додають нові команди. Втулки є автономними бінарними файлами, які дотримуються конвенції іменування kubectl-<назва-втулка>. Спільнота Kubernetes підтримує багато втулків, і ви можете керувати ними за допомогою менеджера втулків Krew.
Сумісність версій
Інструмент kubectl підтримує різницю версій плюс-мінус одну мінорну версію відносно панелі управління кластера. Наприклад, kubectl v1.32 працює з панелями управління в кластерах версій v1.31, v1.32 та v1.33. Використання сумісної версії запобігає непередбачуваній поведінці. Дивіться Політику версійної розбіжності для отримання деталей.
Що далі
Ознайомтеся з довідкою kubectl для отримання відомостей про синтаксис та деталі команд.
У робототехніці та автоматизації control loop (цикл управління) — це нескінченний цикл, який регулює стан системи.
Ось один приклад циклу управління — термостат у кімнаті.
Коли ви встановлюєте температуру, це означає, що ви повідомляєте термостату про бажаний стан. Фактична температура в кімнаті — це поточний стан. Термостат діє так, щоб наблизити поточний стан до бажаного стану, вмикаючи чи вимикаючи відповідне обладнання.
У Kubernetes контролери — це цикли управління, які спостерігають за станом вашого кластера, а потім вносять або запитують зміни там, де це необхідно. Кожен контролер намагається наблизити поточний стан кластера до бажаного.
Шаблон контролера
Контролер відстежує принаймні один тип ресурсу Kubernetes. Ці обʼєкти мають поле spec, яке представляє бажаний стан. Контролер(и) для цього ресурсу відповідають за наближення поточного стану до цього бажаного стану.
Контролер може виконати дію самостійно; частіше в Kubernetes контролер надсилає повідомлення API-серверу, які мають корисні побічні ефекти. Нижче ви побачите приклади цього.
Управління через API-сервер
Контролер Job — це приклад вбудованого контролера Kubernetes. Вбудовані контролери управляють станом, взаємодіючи з API-сервером кластера.
Job — це ресурс Kubernetes, який запускає Pod або, можливо, кілька Podʼів, щоб виконати завдання і потім зупинитися.
(Після процесу планування, обʼєкти Pod стають частиною бажаного стану для kubelet).
Коли контролер Job бачить нове завдання, він переконується, що десь у вашому кластері kubeletʼи на наборі вузлів виконують потрібну кількість Podʼів, щоб виконати роботу. Контролер Job не запускає жодних Podʼів або контейнерів самостійно. Замість цього контролер Job вказує API-серверу створити або видалити Podʼи. Інші компоненти панелі управління реагують на нову інформацію (є нові Podʼи для планування та запуску), і зрештою робота виконується.
Після того, як ви створите нове завдання, бажаний стан полягає в тому, щоб це завдання було завершене. Контролер Job наближає поточний стан цього завдання до бажаного: створює Podʼи, які виконують потрібну вам роботу, щоб завдання було ближчим до завершення.
Контролери також оновлюють обʼєкти, які їх конфігурують. Наприклад, коли роботу для завдання виконано, контролер Job оновлює обʼєкт Job, щоб позначити його як Finished.
(Це трошки схоже на те, як деякі термостати вимикають світловий індикатор, щоб сповістити, що ваша кімната тепер має температуру, яку ви встановили).
Безпосереднє управління
На відміну від Job, деякі контролери повинні вносити зміни за межами вашого кластера.
Наприклад, якщо ви використовуєте цикл управління, щоб переконатися, що у вашому кластері є достатньо вузлів, то цей контролер потребує чогось поза поточним кластером, щоб налаштовувати нові вузли за потреби.
Контролери, які взаємодіють із зовнішнім станом, отримують свій бажаний стан від API-сервера, а потім безпосередньо взаємодіють із зовнішньою системою для наближення поточного стану до бажаного.
(Фактично є контролер, що горизонтально масштабує вузли у вашому кластері).
Важливим тут є те, що контролер вносить певні зміни, щоб досягти вашого бажаного стану, а потім повідомляє поточний стан назад на API-сервер вашого кластера. Інші цикли управління можуть спостерігати за цими даними та виконувати свої дії.
У прикладі з термостатом, якщо в кімнаті дуже холодно, то інший контролер може також увімкнути обігрівач для захисту від морозу. У кластерах Kubernetes панель управління опосередковано працює з інструментами управління IP-адресами, сервісами сховища, API хмарних провайдерів та іншими сервісами, розширюючи Kubernetes для цього.
Бажаний стан порівняно з поточним
Kubernetes дивиться на системи з погляду cloud-native і здатний обробляти постійні зміни.
Ваш кластер може змінюватися в будь-який момент під час роботи, а цикли управління автоматично виправляють збої. Це означає, що, потенційно, ваш кластер ніколи не досягає стабільного стану.
Поки контролери вашого кластера працюють і можуть робити корисні зміни, не має значення, чи є загальний стан сталим, чи ні.
Дизайн
Як принцип дизайну, Kubernetes використовує багато контролерів, кожен з яких керує певним аспектом стану кластера. Найчастіше певний цикл управління (контролер) використовує один вид ресурсу як свій бажаний стан і має інший вид ресурсу, яким він управляє, щоб досягти цього бажаного стану. Наприклад, контролер для ресурсу Job відстежує обʼєкти Job (для виявлення нової роботи) та обʼєкти Pod (для запуску обʼєктів Job і подальшого визначення, коли робота закінчена). У цьому випадку щось інше створює обʼєкти Job, тоді як контролер Job створює Podʼи.
Корисно мати прості контролери, а не один великий набір взаємозалежних циклів управління. Контролери можуть виходити з ладу, тому Kubernetes спроєктовано з урахуванням цього.
Примітка:
Може існувати кілька контролерів, які створюють або оновлюють один і той самий вид обʼєктів. За лаштунками контролери Kubernetes переконуються, що вони звертають увагу лише на ресурси, повʼязані з ресурсом, який ними керує.
Наприклад, ви можете мати ресурси Deployments і Jobs; обидва ці ресурси створюють Podʼи. Контролер Job не видаляє Podʼи, які створив ваш Deployment, оскільки є інформація (мітки), яку контролери можуть використовувати для розрізнення цих Podʼів.
Способи запуску контролерів
Kubernetes постачається з набором вбудованих контролерів, які працюють всередині kube-controller-manager. Ці вбудовані контролери забезпечують важливі основні функції.
Контролер Deployment та контролер Job — це приклади контролерів, які постачаються разом з Kubernetes (контролери, вбудовані в систему). Kubernetes дозволяє вам запускати стійку панель управління, так що, якщо будь-який з вбудованих контролерів не зможе виконувати завдання, інша частина панелі управління візьме на себе його обовʼязки.
Ви можете знайти контролери, які працюють поза панеллю управління, для розширення Kubernetes. Або, якщо ви хочете, ви можете написати новий контролер самостійно. Ви можете запустити свій власний контролер як набір Podʼів, або поза межами Kubernetes. Те, що найкраще підходить, буде залежати від того, що саме робить цей контролер.
Часто в розподілених системах є потреба в лізингу, який забезпечує механізм блокування спільних ресурсів та координації дій між членами групи. У Kubernetes концепцію лізингу представлено обʼєктами Lease в групі APIcoordination.k8s.io, які використовуються для критичних для системи можливостей, таких як пульс вузлів (heartbeats) та вибір лідера на рівні компонентів.
Пульс вузлів
Kubernetes використовує API Lease для передачі пульсу (heartbeats) kubelet вузла на API-сервер Kubernetes. Для кожного Node існує обʼєкт Lease з відповідною назвою в просторі імен kube-node-lease. Під капотом кожен сигнал пульсу kubelet — це запит на оновлення цього обʼєкта Lease, який оновлює поле spec.renewTime для обʼєкта Lease. Панель управління Kubernetes використовує відмітку часу цього поля для визначення доступності цього вузла.
Kubernetes також використовує лізинги, щоб у будь-який момент часу працював лише один екземпляр компонента. Це використовується компонентами панелі управління, такими як kube-controller-manager та kube-scheduler в конфігураціях з високою доступністю, де лише один екземпляр компонента має активно працювати, тоді як інші екземпляри перебувають в режимі очікування.
Прочитайте координовані вибори лідера, щоб дізнатися про те, як Kubernetes використовує Lease API для вибору екземпляра компонента, який буде виконувати роль лідера.
Звільнення блокування вибору лідера kube controller manager під час виходу
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
Коли функціональна можливість ControllerManagerReleaseLeaderElectionLockOnExit увімкнена, kube-controller-manager активно звільняє блокування вибору лідера під час переходу лідерства, замість того, щоб чекати закінчення терміну дії блокування. Це дозволяє швидше обрати нового лідера, зменшуючи затримку переходу лідерства.
Ідентичність API-сервера
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.26; (стандартно увімкнено)
Починаючи з Kubernetes v1.26, кожен kube-apiserver використовує API Lease для публікації своєї ідентичності для решти системи. Хоча це само по собі не є особливо корисним, це забезпечує механізм для клієнтів для визначення кількості екземплярів kube-apiserver, які керують панеллю управління Kubernetes. Наявність лізингів kube-apiserver уможливлює майбутні функції, які можуть потребувати координації між усіма kube-apiserver.
Ви можете перевірити лізинги, якими володіє кожен kube-apiserver, перевіривши обʼєкти лізингу в просторі імен kube-system з назвою apiserver-<sha256-hash>. Або ви можете використовувати селектор міток apiserver.kubernetes.io/identity=kube-apiserver:
kubectl -n kube-system get lease -l apiserver.kubernetes.io/identity=kube-apiserver
NAME                                        HOLDER                                                                           AGE
apiserver-07a5ea9b9b072c4a5f3d1c3702        apiserver-07a5ea9b9b072c4a5f3d1c3702_0c8914f7-0f35-440e-8676-7844977d3a05        5m33s
apiserver-7be9e061c59d368b3ddaf1376e        apiserver-7be9e061c59d368b3ddaf1376e_84f2a85d-37c1-4b14-b6b9-603e62e4896f        4m23s
apiserver-1dfef752bcb36637d2763d1868        apiserver-1dfef752bcb36637d2763d1868_c5ffa286-8a9a-45d4-91e7-61118ed58d2e        4m43s
Хеш SHA256, який використовується в назвах лізингу, базується на імені хоста операційної системи, яке бачить цей API-сервер. Кожен kube-apiserver повинен бути налаштований на використання імені хоста, унікального в межах кластера. Нові екземпляри kube-apiserver, які використовують те саме імʼя хоста, перехоплюють наявні лізинги за допомогою нового ідентифікатора власника, замість того щоб створювати нові обʼєкти лізингу. Ви можете перевірити імʼя хоста, яке використовує kube-apiserver, перевіривши значення мітки kubernetes.io/hostname:
kubectl -n kube-system get lease apiserver-07a5ea9b9b072c4a5f3d1c3702 -o yaml
Прострочені лізинги від kube-apiserver, які вже не існують, прибираються новими kube-apiserver через 1 годину.
Ви можете вимкнути лізинги ідентичності API-сервера, вимкнувши функціональну можливістьAPIServerIdentity.
Робочі навантаження
Ваші власні робочі навантаження можуть визначити своє власне використання лізингів. Наприклад, ви можете запускати власний контролер, де основний член чи лідер виконує операції, яких не виконують інші члени групи. Ви визначаєте лізинг так, щоб репліки контролера могли вибирати чи обирати лідера, використовуючи API Kubernetes для координації. Якщо ви використовуєте лізинг, гарною практикою є визначати назву лізингу, яка очевидно повʼязана з продуктом чи компонентом. Наприклад, якщо у вас є компонент з назвою Example Foo, використовуйте лізинг з назвою example-foo.
Якщо оператор кластера чи інший кінцевий користувач може розгортати кілька екземплярів компонента, виберіть префікс назви та механізм (такий як хеш від назви Deployment), щоб уникнути конфліктів назв лізингів.
Ви можете використовувати інший підхід, якщо він досягає того самого результату: відсутність конфліктів між різними програмними продуктами.
6 - Контейнери
Технологія для пакування застосунку разом із його залежностями часу виконання.
На цій сторінці міститься огляд контейнерів та образів контейнерів, а також їх використання для розробки та промислової експлуатації.
Слово контейнер є дуже перевантаженим терміном. Щоразу, коли ви використовуєте це слово, перевіряйте, чи ваша аудиторія використовує те саме визначення.
Кожен контейнер, який ви запускаєте, є повторюваним; стандартизація завдяки включеним залежностям означає, що ви отримуєте однакову поведінку, де б ви його не запускали.
Контейнери відокремлюють застосунки від базової інфраструктури хоста. Це полегшує розгортання в різних хмарних або ОС-середовищах.
Кожен вузол в кластері Kubernetes запускає контейнери, які формують Podʼи, призначені цьому вузлу. Контейнери в Podʼі розташовуються та плануються разом, щоб запускатися на тому самому вузлі.
Образи контейнерів
Образ контейнера — це готовий до запуску пакунок програмного забезпечення, який містить все необхідне для запуску застосунку: код та будь-яке середовище виконання, якого він потребує, бібліотеки застосунку та системні бібліотеки, а також типові значення для будь-яких важливих налаштувань.
Контейнери призначені для того, щоб бути stateless та незмінними: ви не повинні змінювати код контейнера, який вже працює. Якщо у вас є контейнеризований застосунок та ви хочете внести зміни, правильний процес полягає в тому, щоб зібрати новий образ, який містить ці зміни, а потім створити контейнер заново, щоб запустити його з оновленого образу.
Середовище виконання контейнерів
Основний компонент, який дозволяє Kubernetes ефективно запускати контейнери. Він відповідає за керування виконанням і життєвим циклом контейнерів у середовищі Kubernetes.
Зазвичай ви можете дозволити вашому кластеру обрати стандартне середовище виконання для Podʼа. Якщо вам потрібно використовувати більше одного середовища виконання контейнерів у вашому кластері, ви можете вказати RuntimeClass для Podʼа, щоб переконатися, що Kubernetes запускає ці контейнери за допомогою певного середовища виконання.
Ви також можете використовувати RuntimeClass для запуску різних Podʼів з однаковим середовищем виконання контейнерів, але з різними налаштуваннями.
6.1 - Середовище контейнера
Ця сторінка описує ресурси, доступні контейнерам в середовищі контейнера.
Середовище контейнера
Середовище контейнера Kubernetes надає кілька важливих ресурсів контейнерам:
Файлову систему, яка є комбінацією образу та одного чи декількох томів.
Інформацію про сам контейнер.
Інформацію про інші обʼєкти в кластері.
Інформація про контейнер
hostname контейнера — це назва Podʼа, в якому він працює. Вона доступна через команду hostname або виклик функції gethostname у бібліотеці libc.
Назва та простір імен Podʼа доступні як змінні середовища через downward API.
Змінні середовища, визначені користувачем у визначенні Podʼа, також доступні для контейнера, так само як будь-які статично визначені змінні середовища в образі контейнера.
Інформація про кластер
Список всіх сервісів, які були активні під час створення контейнера, доступний цьому контейнеру як змінні середовища. Цей список обмежений сервісами в межах того ж простору імен, що й новий Pod контейнера, та сервісами панелі управління Kubernetes.
Для сервісу з назвою foo, який експонує набір Podʼів, кожен з яких виконує контейнер із назвою bar, визначаються такі змінні:
FOO_SERVICE_HOST=<хост, на якому працює сервіс>
FOO_SERVICE_PORT=<порт, на якому працює сервіс>
Сервіси мають виділені IP-адреси, які доступні для контейнера через DNS, якщо увімкнено надбудову DNS.
На цій сторінці описано, як контейнери, керовані kubelet, можуть використовувати фреймворк хуків життєвого циклу контейнера для запуску коду, викликаного подіями під час управління їх життєвим циклом.
Огляд
Аналогічно багатьом фреймворкам програмування, які мають хуки життєвого циклу компонентів, таким як Angular, Kubernetes надає контейнерам хуки життєвого циклу. Ці хуки дозволяють контейнерам бути в курсі подій у своєму циклі управління та виконувати код, реалізований в обробнику, коли відповідний хук життєвого циклу виконується.
Хуки контейнера
Контейнерам доступні два хуки:
PostStart
Цей хук виконується відразу після створення контейнера. Він працює одночасно з ENTRYPOINT контейнера (головним процесом), що означає, що хук може виконуватися до, під час або після запуску головного процесу.
До обробника не передаються жодні параметри.
Примітка:
Хоча хук працює одночасно з процесом контейнера,
він може затримувати оновлення статусу контейнера; контейнер може не переходити в стан Running до завершення роботи хука.
PreStop
Цей хук викликається негайно перед тим, як контейнер буде завершено через запит API або подію управління, таку як невдача проби на живучість/запуску, витіснення, конкуренція за ресурси та інші. Виклик хука PreStop не вдасться, якщо контейнер вже перебуває у стані terminated або completed, і хук повинен завершити виконання до того, як може бути відправлений сигнал TERM для зупинки контейнера. Відлік пільгового періоду припинення Podʼа починається до виконання хука PreStop, тому, незалежно від результату обробника, контейнер врешті-решт завершиться протягом пільгового періоду припинення Podʼа. Жодні параметри не передаються обробнику.
За допомогою хука життєвого циклу StopSignal можна визначити сигнал зупинки, який буде надіслано контейнеру, коли його буде зупинено. Якщо ви встановите цей параметр, він перевизначить будь-яку інструкцію STOPSIGNAL, визначену в образі контейнера.
Детальніший опис поведінки завершення за допомогою власних сигналів зупинки можна знайти в розділі Сигнали зупинки.
Реалізації обробника хуків
Контейнери можуть мати доступ до хука, реалізувавши та зареєструвавши обробник для цього хука. Існують три типи обробників хука, які можна реалізувати для контейнерів:
Exec — Виконує конкретну команду, таку як pre-stop.sh, всередині cgroups та namespaces контейнера. Ресурси, спожиті командою, зараховуються на рахунок контейнера.
HTTP — Виконує HTTP-запит до конкретного endpoint в контейнері.
Sleep — Призупиняє контейнер на вказаний час.
Виконання обробника хука
Коли викликається хук управління життєвим циклом контейнера, система управління Kubernetes виконує обробник відповідно до дії хука: httpGet, tcpSocket (застаріло) та sleep виконуються процесом kubelet, а exec виконується в контейнері.
Виклик обробника хука PostStart ініціюється при створенні контейнера, тобто точка входу контейнера ENTRYPOINT і хук PostStart спрацьовують одночасно. (Це означає, що, як правило, не має сенсу використовувати HTTP-хук для PostStart, оскільки немає гарантії, що процес контейнера буде повністю запущений, коли хук запуститься.) Якщо хук PostStart виконується занадто довго або зависає, це може завадити контейнеру перейти у стан running.
Хуки PreStop не викликаються асинхронно від сигналу зупинки контейнера; хук повинен завершити своє виконання до того, як може бути відправлений сигнал TERM. Якщо хук PreStop зависає під час виконання, фаза Podʼа буде Terminating і залишиться такою, поки Pod не буде вбито після закінчення його terminationGracePeriodSeconds. Цей період припинення роботи застосовується до загального часу, необхідного як для виконання хука PreStop, так і для зупинки контейнера. Якщо, наприклад, terminationGracePeriodSeconds дорівнює 60, і хук займає 55 секунд для завершення, а контейнер зупиняється нормально через 10 секунд після отримання сигналу, то контейнер буде вбитий перш, ніж він зможе завершити роботу, оскільки terminationGracePeriodSeconds менше, ніж загальний час (55+10), необхідний для цих двох подій.
Якщо хук PostStart або PreStop завершується збоєм, контейнер буде вбито.
Користувачам слід робити свої обробники хуків якомога легкими. Проте є випадки, коли тривалі команди мають сенс, наприклад, коли потрібно зберегти стан перед зупинкою контейнера.
Гарантії доставки хуків
Доставка хука має відбуватися щонайменше один раз, що означає, що хук може бути викликано кілька разів для будь-якої події, такої як для PostStart чи PreStop. Реалізація хука повинна правильно це обробляти.
Як правило, здійснюються лише разові доставки. Якщо, наприклад, приймач HTTP-хука не працює і не може приймати трафік, спроба повторно надіслати не відбувається. Однак у деяких рідкісних випадках може статися подвійна доставка. Наприклад, якщо kubelet перезапускається посеред надсилання хука, хук може бути повторно відправлений після того, як kubelet знову запрацює.
Налагодження обробників хуків
Логи обробника хука не відображаються в подіях Podʼа. Якщо обробник зазнає збою з будь-якої причини, він розсилає подію. Для PostStart це подія FailedPostStartHook, а для PreStop це подія FailedPreStopHook. Щоб самостійно згенерувати подію FailedPostStartHook, змініть файл lifecycle-events.yaml, замінивши команду postStart на "badcommand", і застосуйте його. Ось приклад виводу події, який ви побачите після виконання kubectl describe pod lifecycle-demo:
Events:
  Type     Reason               Age              From               Message
  ----     ------               ----             ----               -------
  Normal   Scheduled            7s               default-scheduler  Successfully assigned default/lifecycle-demo to ip-XXX-XXX-XX-XX.us-east-2...
  Normal   Pulled               6s               kubelet            Successfully pulled image "nginx" in 229.604315ms
  Normal   Pulling              4s (x2 over 6s)  kubelet            Pulling image "nginx"
  Normal   Created              4s (x2 over 5s)  kubelet            Created container lifecycle-demo-container
  Normal   Started              4s (x2 over 5s)  kubelet            Started container lifecycle-demo-container
  Warning  FailedPostStartHook  4s (x2 over 5s)  kubelet            Exec lifecycle hook ([badcommand]) for Container "lifecycle-demo-container" in Pod "lifecycle-demo_default(30229739-9651-4e5a-9a32-a8f1688862db)" failed - error: command 'badcommand' exited with 126: , message: "OCI runtime exec failed: exec failed: container_linux.go:380: starting container process caused: exec: \"badcommand\": executable file not found in $PATH: unknown\r\n"
  Normal   Killing              4s (x2 over 5s)  kubelet            FailedPostStartHook
  Normal   Pulled               4s               kubelet            Successfully pulled image "nginx" in 215.66395ms
  Warning  BackOff              2s (x2 over 3s)  kubelet            Back-off restarting failed container
У Linux контрольні групи обмежують ресурси, які виділяються процесам.
kubelet та середовище виконання контейнерів повинні співпрацювати з cgroups для забезпечення управління ресурсами для Podʼів та контейнерів, що включає запити та обмеження CPU/памʼяті для контейнеризованих робочих навантажень.
Є дві версії cgroups у Linux: cgroup v1 і cgroup v2. cgroup v2 — це нове покоління API cgroup в Linux.
Що таке cgroup v2?
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
cgroup v2 — це наступне покоління API Linux cgroup. cgroup v2 надає єдину систему управління з розширеними можливостями управління ресурсами.
cgroup v2 пропонує кілька поліпшень порівняно з cgroup v1, таких як:
Розширене управління розподілом ресурсів та ізоляція між різними ресурсами
Обʼєднаний облік різних типів виділення памʼяті (мережева памʼять, памʼять ядра і т. д.)
Облік відкладених змін ресурсів, таких як запис кешу сторінок
Деякі можливості Kubernetes використовують виключно cgroup v2 для поліпшення управління ресурсами та ізоляцією. Наприклад, можливість MemoryQoS покращує якість обслуговування памʼяті та покладається на примітиви cgroup v2.
Використання cgroup v2
Рекомендованим способом використання cgroup v2 є використання дистрибутиву Linux, який стандартно вмикає та використовує cgroup v2.
kubelet та середовище виконання контейнерів налаштовані на використання cgroup-драйвера systemd
Підтримка cgroup v2 дистрибутивами Linux
Для ознайомлення зі списком дистрибутивів Linux, які використовують cgroup v2, див. документацію cgroup v2
Container Optimized OS (з версії M97)
Ubuntu (з версії 21.10, рекомендовано 22.04+)
Debian GNU/Linux (з Debian 11 bullseye)
Fedora (з версії 31)
Arch Linux (з квітня 2021)
RHEL та схожі дистрибутиви (з версії 9)
Щоб перевірити, чи ваш дистрибутив використовує cgroup v2, див. документацію вашого дистрибутиву або скористайтеся інструкціями в Визначенні версії cgroup на вузлах Linux.
Також можна увімкнути cgroup v2 вручну у вашому дистрибутиві Linux, змінивши аргументи завантаження ядра. Якщо ваш дистрибутив використовує GRUB, systemd.unified_cgroup_hierarchy=1 повинно бути додано в GRUB_CMDLINE_LINUX в /etc/default/grub, а потім виконайте sudo update-grub. Однак рекомендованим підходом є використання дистрибутиву, який вже стандартно вмикає cgroup v2.
Міграція на cgroup v2
Щоб перейти на cgroup v2, переконайтеся, що ваша система відповідає вимогам, а потім оновіть її до версії ядра, яка стандартно вмикає cgroup v2.
Kubelet автоматично виявляє, що ОС працює з cgroup v2 і діє відповідно без додаткової конфігурації.
При переході на cgroup v2 не повинно бути помітної різниці в використанні, якщо користувачі не звертаються безпосередньо до файлової системи cgroup чи на вузлі, чи зсередини контейнерів.
cgroup v2 використовує інший API, ніж cgroup v1, тому, якщо є застосунки, які безпосередньо отримують доступ до файлової системи cgroup, вони повинні бути оновлені до новіших версій, які підтримують cgroup v2. Наприклад:
Деякі сторонні агенти моніторингу та безпеки можуть залежати від файлової системи cgroup. Оновіть ці агенти до версій, які підтримують cgroup v2.
Якщо ви використовуєте cAdvisor як окремий DaemonSet для моніторингу Podʼів та контейнерів, оновіть його до v0.43.0 чи новіше.
Якщо ви розгортаєте Java-застосунки, віддайте перевагу використанню версій, які повністю підтримують cgroup v2:
Якщо ви використовуєте пакунок uber-go/automaxprocs, переконайтеся, що ви використовуєте версію v1.5.1 чи вище.
Якщо ви розгортаєте застосунки на Node.js, віддавайте перевагу версіям, які виявляють обмеження памʼяті cgroup v2. Node.js читає обмеження памʼяті cgroup v2 (через libuv) починаючи з Node.js v20.3.0. Лінія випуску v18 ненадійно виявляє обмеження памʼяті cgroup v2. Версії без цієї підтримки можуть читати загальну памʼять хоста замість обмеження, застосованого до Podʼа, що може призвести до неправильного розміру heap і завершення роботи через нестачу памʼяті (OOM). У версіях, яких це стосується, встановіть розмір heap явно, наприклад за допомогою прапорця --max-old-space-size.
Визначення версії cgroup на вузлах Linux
Версія cgroup залежить від використаного дистрибутиву Linux та версії cgroup, налаштованої в ОС. Щоб перевірити, яка версія cgroup використовується вашим дистрибутивом, виконайте команду stat -fc %T /sys/fs/cgroup/ на вузлі:
stat -fc %T /sys/fs/cgroup/
Для cgroup v2 вивід — cgroup2fs.
Для cgroup v1 вивід — tmpfs.
Визнання застарілим cgroup v1
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.35
Kubelet більше стандартно не буде запускатися на вузлі cgroup v1. Щоб вимкнути це налаштування, адміністратор кластера повинен встановити failCgroupV1 на false у файлі конфігурації kubelet.
Kubernetes розроблено з можливостями самозцілення, які допомагають підтримувати працездатність і доступність робочих навантажень. Він автоматично замінює збійні контейнери, переплановує робочі навантаження, коли вузли стають недоступними, і забезпечує підтримку бажаного стану системи.
Можливості самозцілення
Перезапуски на рівні контейнера: Якщо контейнер всередині Podʼа виходить з ладу, Kubernetes перезапускає його відповідно до restartPolicy.
Заміна реплік: Якщо Pod у Deployment або StatefulSet виходить з ладу, Kubernetes створює Pod на заміну, щоб підтримувати вказану кількість реплік. Якщо Pod, який є частиною DaemonSet, виходить з ладу, панель управління створює Pod на заміну для запуску на тому самому вузлі.
Відновлення постійного сховища: Якщо на вузлі працює Pod з підключеним PersistentVolume (PV), і вузол виходить з ладу, Kubernetes може повторно приєднати том до нового Podʼа на іншому вузлі.
Балансування навантаження для Services: Якщо Pod, що перебуває за Service, виходить з ладу, Kubernetes автоматично видаляє його з точок доступу Service, щоб направляти трафік лише до справних Podʼів.
Ось деякі з ключових компонентів, які забезпечують самозцілення Kubernetes:
kubelet: Забезпечує роботу контейнерів і перезапускає ті, які вийшли з ладу.
Контролери Deployment (через ReplicaSet), ReplicaSet, StatefulSet і DaemonSet: Підтримують бажану кількість реплік Podʼа.
Контролер PersistentVolume: Керує приєднанням і відʼєднанням томів для робочих навантажень зі збереженням стану.
Візьміть до уваги
Збої в сховищі: Якщо постійний том стає недоступним, можуть знадобитися кроки відновлення.
Помилки застосунків: Kubernetes може перезапускати контейнери, але проблеми в самому застосунку необхідно вирішувати окремо.
Читайте про автомасштабування вузлів. Автомасштабування вузлів також забезпечує автоматичне відновлення, якщо вузли виходять з ладу у вашому кластері.
10 - Сервіси, балансування навантаження та мережа
11 - Збір сміття
Збір сміття — це загальний термін для різних механізмів, які Kubernetes використовує для очищення ресурсів кластера. Це дозволяє очищати ресурси, такі як:
Багато обʼєктів в Kubernetes повʼязані один з одним через посилання на власника. Посилання на власника повідомляють панелі управління, які обʼєкти залежать від інших. Kubernetes використовує посилання на власника для того, щоб дати панелі управління та іншим клієнтам API можливість очищати повʼязані ресурси перед видаленням обʼєкта. У більшості випадків Kubernetes автоматично керує посиланнями на власника.
Власність відрізняється від механізму міток та селекторів, які також використовують деякі ресурси. Наприклад, розгляньте Service, який створює обʼєкти EndpointSlice. Service використовує мітки, щоб дозволити панелі управління визначити, які обʼєкти EndpointSlice використовуються для цього Service. Окрім міток, кожен обʼєкт EndpointSlice, керований від імені Service, має посилання на власника. Посилання на власника допомагають різним частинам Kubernetes уникати втручання в обʼєкти, якими вони не керують.
Примітка:
Посилання на власника з іншого простору імен заборонені за задумом. Залежні обʼєкти в межах простору імен можуть вказувати власників рівня кластера або рівня простору імен. Власник рівня простору імен повинен існувати в тому самому просторі імен, що й залежний обʼєкт. Якщо це не так, таке посилання вважається відсутнім, і залежний обʼєкт підлягає видаленню після перевірки відсутності всіх власників.
Залежні обʼєкти рівня кластера можуть вказувати тільки власників рівня кластера. У v1.20+, якщо залежний обʼєкт рівня кластера вказує як власника тип у межах простору імен, вважається, що він має нерозвʼязне посилання на власника, і його не можна прибрати збором сміття.
У v1.20+, якщо збирач сміття виявляє недійсний ownerReference між просторами імен або залежний обʼєкт рівня кластера з ownerReference, що посилається на тип у межах простору імен, повідомляється про попереджувальну подію з причиною OwnerRefInvalidNamespace та involvedObject недійсного залежного елемента. Ви можете перевірити наявність такого роду подій, запустивши kubectl get events -A --field-selector=reason=OwnerRefInvalidNamespace.
Каскадне видалення
Kubernetes перевіряє та видаляє обʼєкти, які більше не мають посилань на власника, наприклад, Podʼи, які залишилися після видалення ReplicaSet. Коли ви видаляєте обʼєкт, ви можете контролювати, чи автоматично видаляє Kubernetes залежні обʼєкти, у процесі, що називається каскадним видаленням. Існують два типи каскадного видалення:
Каскадне видалення на передньому плані
Каскадне видалення у фоні
Ви також можете контролювати те, як і коли збір сміття видаляє ресурси, які мають посилання на власника, використовуючи завершувачі Kubernetes.
Каскадне видалення на передньому плані
У каскадному видаленні на передньому плані обʼєкт власника, який видаляється, спочатку потрапляє в стан deletion in progress. У цьому стані з обʼєктом власника відбувається таке:
API-сервер Kubernetes встановлює поле metadata.deletionTimestamp обʼєкта на час, коли обʼєкт був позначений на видалення.
API-сервер Kubernetes також встановлює поле metadata.finalizers в foregroundDeletion.
Обʼєкт залишається видимим через API Kubernetes, поки не буде завершений процес видалення.
Після того як обʼєкт власника потрапляє в стан deletion in progress, контролер видаляє відомі йому залежні обʼєкти. Після видалення всіх відомих залежних обʼєктів контролер видаляє обʼєкт власника. На цьому етапі обʼєкт більше не є видимим в API Kubernetes.
Під час каскадного видалення на передньому плані єдиними залежними обʼєктами, які блокують видалення власника, є ті, що мають поле ownerReference.blockOwnerDeletion=true і перебувають у кеші контролера збору сміття. Кеш контролера збору сміття може не містити обʼєкти, тип ресурсу яких не вдається успішно перелічити / відстежувати, або обʼєкти, які створюються одночасно з видаленням обʼєкта-власника. Дивіться Використання каскадного видалення на передньому плані, щоб дізнатися більше.
Каскадне видалення у фоні
Під час фонового каскадного видалення API-сервер Kubernetes негайно видаляє обʼєкт-власник, а контролер збирача сміття (ваш власний або стандартний) очищає залежні обʼєкти у фоновому режимі. Якщо існує завершувач, він гарантує, що обʼєкти не будуть видалені, доки не будуть виконані всі необхідні завдання з очищення. Типово Kubernetes використовує каскадне видалення у фоні, якщо ви не використовуєте видалення вручну на передньому плані або не вибираєте залишити залежні обʼєкти.
Коли Kubernetes видаляє обʼєкт власника, залишені залежні обʼєкти називаються залишеними обʼєктами. Типово Kubernetes видаляє залежні обʼєкти. Щоб дізнатися, як перевизначити цю поведінку, дивіться Видалення власників та залишені залежності.
Збір сміття невикористаних контейнерів та образів
kubelet виконує збір сміття невикористаних образів кожні пʼять хвилин та невикористаних контейнерів кожну хвилину. Ви повинні уникати використання зовнішніх інструментів для збору сміття, оскільки вони можуть порушити поведінку kubelet та видаляти контейнери, які повинні існувати.
Щоб налаштувати параметри для збору сміття невикористаних контейнерів та образів, налаштуйте kubelet за допомогою файлу конфігурації та змініть параметри, повʼязані зі збором сміття, використовуючи ресурс типу KubeletConfiguration.
Життєвий цикл образу контейнера
Kubernetes керує життєвим циклом всіх образів через свій менеджер образів, який є частиною kubelet, співпрацюючи з cadvisor. Kubelet враховує такі обмеження щодо використання дискового простору під час прийняття рішень про збір сміття:
HighThresholdPercent
LowThresholdPercent
Використання дискового простору вище встановленого значення HighThresholdPercent викликає збір сміття, який видаляє образи в порядку їх останнього використання, починаючи з найстаріших. Kubelet видаляє образи до тих пір, поки використання дискового простору не досягне значення LowThresholdPercent.
Збір сміття для невикористаних контейнерних образів
Ви можете вказати максимальний час, протягом якого локальний образ може бути невикористаний, незалежно від використання дискового простору. Це налаштування kubelet, яке ви вказуєте для кожного вузла.
Щоб налаштувати параметр, встановіть значення поля imageMaximumGCAge у файлі конфігурації kubelet.
Значення вказується як тривалість. Дивіться визначення тривалості в глосарії для отримання докладних відомостей.
Наприклад, ви можете встановити значення поля конфігурації 12h45m, що означає 12 годин 45 хвилин.
Примітка:
Ця функція не відстежує використання образів між перезапусками kubelet. Якщо kubelet перезапускається, вік відстежуваного образу скидається, що призводить до того, що kubelet очікує повний проміжок часу imageMaximumGCAge перш ніж вважати образ придатним для збору сміття на основі його віку.
Збір сміття контейнерів
Kubelet збирає сміття невикористаних контейнерів на основі таких змінних, які ви можете визначити:
MinAge: мінімальний вік, за якого kubelet може видаляти контейнер. Щоб вимкнути, встановіть значення 0.
MaxPerPodContainer: максимальна кількість мертвих контейнерів, які може мати кожен Pod. Щоб вимкнути, встановіть значення менше 0.
MaxContainers: максимальна кількість мертвих контейнерів у кластері. Щоб вимкнути, встановіть значення менше 0.
Крім цих змінних, kubelet збирає сміття невизначених та видалених контейнерів, як правило, починаючи з найстарших.
MaxPerPodContainer та MaxContainers можуть потенційно конфліктувати одне з одним в ситуаціях, де збереження максимальної кількості контейнерів на кожен Pod (MaxPerPodContainer) перевищить допустиму загальну кількість глобальних мертвих контейнерів (MaxContainers). У цій ситуації kubelet коригує MaxPerPodContainer для вирішення конфлікту. У найгіршому випадку може бути знижений MaxPerPodContainer до 1 та виселені найдавніші контейнери. Крім того, контейнери, які належать Podʼам, які були видалені, видаляються, коли стають старшими за MinAge.
Примітка:
Kubelet збирає сміття лише для контейнерів, якими він керує.
Налаштування збору сміття
Ви можете налаштовувати збір сміття ресурсів, налаштовуючи параметри, специфічні для контролерів, що керують цими ресурсами. На наступних сторінках показано, як налаштовувати збір сміття:
Дізнайтеся про контролер TTL, який очищає завершені завдання.
12 - Сховища інформації
13 - Конфігурація
14 - Проксі змішаних версій
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
У Kubernetes 1.37 включено бета-функцію, яка дозволяє API-серверу проксіювати запити ресурсів до інших рівноправних API-серверів. Це також дозволяє клієнтам отримати цілісне уявлення про ресурси, що обслуговуються в усьому кластері, за допомогою виявлення. Це корисно, коли існують кілька API-серверів, що працюють на різних версіях Kubernetes в одному кластері (наприклад, під час тривалого впровадження нового релізу Kubernetes).
Це дозволяє адміністраторам кластерів налаштовувати високодоступні кластери, які можна оновлювати безпечніше:
гарантуючи, що контролери, які покладаються на виявлення для показу повного списку ресурсів для важливих завдань, завжди отримують повний огляд усіх ресурсів. Ми називаємо це повним виявленням у масштабі кластера — Peer-aggregated discovery.
направляючи запити на ресурси (зроблені під час оновлення) на відповідний kube-apiserver. Це проксіювання запобігає появі у користувачів несподіваних помилок 404 Not Found, спричинених процесом оновлення. Цей механізм називається Mixed Version Proxy.
Активація Peer-aggregated Discovery та Mixed Version Proxy
kube-apiserver \
--feature-gates=UnknownVersionInteroperabilityProxy=true\
# обовʼязкові аргументи командного рядка для цієї функції--peer-ca-file=<шлях до сертифіката CA kube-apiserver>
--proxy-client-cert-file=<шлях до сертифіката агрегатора проксі>,
--proxy-client-key-file=<шлях до ключа агрегатора проксі>,
--requestheader-client-ca-file=<шлях до сертифіката CA агрегатора>,
# requestheader-allowed-names може бути встановлено як порожнє значення, щоб дозволити будь-яке Common Name--requestheader-allowed-names=<дійсні значення Common Name для перевірки сертифіката клієнта проксі>,
# необовʼязкові прапорці для цієї функції--peer-advertise-ip=`IP цього kube-apiserver, який повинні використовувати рівноправні сервери для проксіювання запитів`--peer-advertise-port=`порт цього kube-apiserver, який повинні використовувати рівноправні сервери для проксіювання запитів`# …і інші прапорці як зазвичай
Транспорт та автентифікація проксі між API-серверами
Вихідний kube-apiserver повторно використовує
наявні прапорці автентифікації клієнта API-сервера--proxy-client-cert-file та --proxy-client-key-file для представлення своєї ідентичності, яку перевіряє рівноправний сервер (цільовий kube-apiserver). Цільовий API-сервер перевіряє це підключення на основі конфігурації, яку ви вказуєте за допомогою аргументу командного рядка --requestheader-client-ca-file.
Для автентифікації сертифікатів цільового сервера вам слід налаштувати пакет сертифікатів центру сертифікації, вказавши аргумент командного рядка --peer-ca-fileвихідному API-серверу.
Налаштування для зʼєднання з рівноправним API-сервером
Для встановлення мережевого розташування kube-apiserver, яке рівноправні сервери будуть використовувати для проксіювання запитів, використовуйте аргументи командного рядка --peer-advertise-ip та --peer-advertise-port для kube-apiserver або вказуйте ці поля в конфігураційному файлі API-сервера. Якщо ці прапорці не вказані, рівноправні сервери будуть використовувати значення з аргументів командного рядка --advertise-address або --bind-address для kube-apiserver. Якщо ці прапорці теж не встановлені, використовується типовий інтерфейс хоста.
Peer-aggregated discovery
Коли ви вмикаєте цю функцію, запити на виявлення автоматично вмикаються для надання комплексного документа виявлення (з переліком усіх ресурсів, що обслуговуються будь-яким apiserver у кластері) стандартно.
Якщо ви хочете запросити документ non peer-aggregated discovery, ви можете вказати це, додавши до запиту на виявлення такий заголовок Accept:
Коли ви вмикаєте проксіювання змішаних версій, шар агрегації завантажує спеціальний фільтр, який виконує такі дії:
Коли запит ресурсу надходить до API-сервера, який не може обслуговувати цей API (чи то тому, що його версія старіша за появу цього API, чи тому, що API вимкнено на API-сервері), API-сервер намагається надіслати запит до рівноправного API-сервера, який може обслуговувати затребуваний API. Це відбувається шляхом ідентифікації груп API / версій / ресурсів, які локальний сервер не розпізнає, і спроби проксіювати ці запити до рівноправного API-сервера, який може обробити запит.
Якщо рівноправний API-сервер не відповідає, то вихідний API-сервер відповідає помилкою 503 ("Service Unavailable").
Як це працює під капотом
Коли API-сервер отримує запит ресурсу, він спочатку перевіряє, які API-сервери можуть обслуговувати затребуваний ресурс. Ця перевірка відбувається за допомогою документа non peer-aggregated discovery.
Якщо ресурс є в документі non peer-aggregated discovery, отриманому від API-сервера, що отримав запит (наприклад, GET /api/v1/pods/some-pod), запит обробляється локально.
Якщо ресурс у запиті (наприклад, GET /apis/resource.k8s.io/v1beta1/resourceclaims) не знайдено в документі non peer-aggregated discovery, отриманому з API-сервера, який намагається обробити запит (API-сервер обробки), ймовірно, через те, що API resource.k8s.io/v1beta1 був введений в новій версії Kubernetes, а API-сервер обробки працює на старій версії, яка його не підтримує, тоді API-сервер обробки знаходить рівноправні API-сервери, які обслуговують відповідну групу API / версію / ресурс (у цьому випадку resource.k8s.io/v1beta1/resourceclaims) перевіряючи документи non peer-aggregated discovery усіх рівноправних API-серверів. Потім API-сервер обробки проксіює запит до одного з відповідних рівноправних kube-apiserver, які знають про запитуваний ресурс.
Якщо для цієї групи API / версії / ресурсу немає відомого рівноправного сервера, API-сервер обробки передає запит до власного ланцюжка обробників, який повинен зрештою повернути відповідь 404 ("Not Found").
Якщо API-сервер обробки визначив і вибрав рівноправний API-сервер, але той не відповідає (через проблеми з підключенням до мережі або стан гонитви між отриманням запиту та реєстрацією контролером інформації про рівноправний сервер у панелі управління), API-сервер обробки відповідає помилкою 503 ("Service Unavailable").
15 - Розширення можливостей Kubernetes
Різні способи зміни поведінки вашого кластера Kubernetes.
15.1 - Шаблон Operator
Оператори — це розширення програмного забезпечення для Kubernetes, які використовують власні ресурси для управління застосунками та їх компонентами. Оператори дотримуються принципів Kubernetes, зокрема control loop.
Мотивація
Шаблон operator спрямований на досягнення ключової мети людини-оператора, яка керує сервісом або набором сервісів. Люди-оператори, які відповідають за конкретні застосунки та сервіси, мають глибокі знання про те, як система повинна себе вести, як її розгорнути та як реагувати у разі проблем.
Люди, які запускають робочі навантаження в Kubernetes, часто хочуть використовувати автоматизацію для виконання повторюваних завдань. Шаблон operator показує, як ви можете написати код для автоматизації завдання, яке виходить за межі того, що надає сам Kubernetes.
Оператори в Kubernetes
Kubernetes створений для автоматизації. З коробки ви отримуєте багато вбудованої автоматизації від ядра Kubernetes. Ви можете використовувати Kubernetes для автоматизації розгортання та запуску робочих навантажень, та ви можете автоматизувати те, як це робить Kubernetes.
Концепція шаблону operator Kubernetes дозволяє розширити поведінку кластера без зміни коду самого Kubernetes, звʼязавши контролери з одним або кількома власними ресурсами. Оператори є клієнтами API Kubernetes, які діють як контролери для власного ресурсу.
Приклад оператора
Деякі завдання, які можна автоматизувати за допомогою оператора, включають:
розгортання застосунку за запитом
створення та відновлення резервних копій стану цього застосунку
керування оновленнями коду застосунку разом з повʼязаними змінами, такими як схеми баз даних або додаткові налаштування
публікація Serviceʼів для застосунків, які не підтримують Kubernetes API, для їх виявлення
емуляція відмови в усьому або частині кластера для перевірки його стійкості
обрання лідера для розподіленого застосунку без внутрішнього процесу такого вибору.
Яким може бути оператор у більш детальному вигляді? Ось приклад:
Власний ресурс з назвою SampleDB, який можна налаштувати в кластері.
Deployment, який запускає Pod, що містить частину контролера оператора.
Образ контейнера з кодом оператора.
Код контролера, який надсилає запити до панелі управління, щоб дізнатися, яким чином налаштовано ресурси SampleDB.
Ядром оператора є код, який говорить API серверу, які дії потрібно виконати, щоб поточний стан ресурсу SampleDB відповідав бажаному стану ресурсів.
Якщо ви додаєте новий ресурс SampleDB, оператор створює PersistentVolumeClaim для забезпечення місця для надійного зберігання даних, StatefulSet — для запуску SampleDB, та завдання (Job) для ініціалізації бази даних.
Якщо ви видаляєте ресурс SampleDB, оператор зробить зліпок з усіх даних, потім переконається, що ресурси StatefulSet та Volume також видалені.
Оператор також керує процесом створення резервних копій бази даних. Для кожного ресурсу SampleDB оператор визначає, коли потрібно створити Pod, який підʼєднається до бази даних, та зробить резервну копію. Ці Podʼи можуть використовувати ConfigMap чи Secret, що містять облікові дані для підʼєднання до бази даних.
Оскільки оператор призначений для надання високого рівня автоматизації для керування ресурсами, тож для цього може використовуватись додатковий код. Наприклад, код, що визначає, чи база даних працює на старій версії, та якщо так, то створює Job для оновлення бази даних.
Розгортання операторів
Найпоширеніший спосіб розгортання операторів — це додавання CustomResourceDefinition (CRD) та контролера для них до вашого кластера. Контролери мають зазвичай запускатись за межами панелі управління кластера, так само як ви запускаєте будь-який інший контейнеризований застосунок. Наприклад, ви можете запустити ваш контролер як Deployment.
Використання операторів
Після того, як ви розгорнете оператора, ви будете використовувати його, додаючи, змінюючи або видаляючи тип ресурсу, який використовує оператор. Наслідуючи наведений вище приклад, ви б налаштували розгортання для самого оператора, а потім:
kubectl get SampleDB # пошук налаштованої бази данихkubectl edit SampleDB/example-database # ручна заміна деяких параметрів
…і все! Оператор візьме на себе роботу застосування змін, а такою як і підтримання сервісу у відповідному стані.
Створення власних операторів
Якщо в екосистемі немає оператора, який реалізує потрібну вам поведінку, ви можете створити власний.
Ви також можете створити оператор (тобто, Контролер) використовуючи мову або рушій виконання, який працює як клієнт API Kubernetes.
Нижче наведено кілька бібліотек та інструментів, які ви можете використовувати для написання власного хмарного оператора.
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.