Це багатосторінковий друкований вигляд цього розділу. Натисність щоб друкувати.
Огляд
- 1: Компоненти Kubernetes
- 2: Що таке Kubernetes?
- 3: Обʼєкти в Kubernetes
- 3.1: Управління обʼєктами Kubernetes
- 3.2: Назви та ідентифікатори обʼєктів
- 3.3: Власники та залежності
- 3.4: Рекомендовані мітки
- 3.5: Версії зберігання
- 4: Інструмент командного рядка kubectl
1 - Компоненти Kubernetes
Ця сторінка містить огляд основних компонентів, з яких складається кластер Kubernetes.

Компоненти кластера Kubernetes
Основні компоненти
Кластер Kubernetes складається з панелі управління та одного або декількох робочих вузлів. Ось короткий огляд основних компонентів:
Компоненти панелі управління
Керують загальним станом кластера:
- kube-apiserver
- Основний серверний компонент, який надає HTTP API Kubernetes.
- etcd
- Узгоджене та високодоступне сховище ключ-значення для всіх даних API-сервера.
- kube-scheduler
- Шукає ще не привʼязані до вузла Podʼи та призначає кожен Pod до відповідного вузла.
- kube-controller-manager
- Запускає контролери для реалізації поведінки API Kubernetes.
- cloud-controller-manager (необовʼязково)
- Інтегрується з базовими хмарними провайдерами.
Компоненти вузлів
Запускаються на кожному вузлі, підтримуючи запущені Podʼи та надаючи середовище виконання Kubernetes:
- kubelet
- Забезпечує роботу Podʼів, включно з їхніми контейнерами.
- kube-proxy (необовʼязково)
- Підтримує мережеві правила на вузлах для реалізації Services.
- Середовище виконання контейнерів
- Програмне забезпечення, відповідальне за запуск контейнерів. Дивіться Середовище виконання контейнерів, щоб дізнатись більше.
Ваш кластер може потребувати додаткового програмного забезпечення на кожному вузлі; наприклад, ви можете також запускати systemd на вузлі Linux для контролю локальних компонентів.
Надбудови
Надбудови розширюють функціональність Kubernetes. Ось кілька важливих прикладів:
- DNS
- Для DNS-розвʼязання на рівні всього кластера.
- Вебінтерфейс (Dashboard)
- Для керування кластером через вебінтерфейс.
- Моніторинг ресурсів контейнерів
- Для збирання та зберігання метрик контейнерів.
- Логування на рівні кластера
- Для збереження логів контейнерів у централізованому сховищі логів.
Гнучкість архітектури
Kubernetes дозволяє гнучко розгортати ці компоненти та керувати ними. Архітектуру можна адаптувати до різних потреб, від невеликих середовищ розробки до великомасштабних промислових розгортань.
Для отримання більш детальної інформації про кожен компонент та різні способи налаштування кластерної архітектури, дивіться сторінку Архітектура кластера.
2 - Що таке Kubernetes?
Ця сторінка являє собою узагальнений огляд Kubernetes.
Kubernetes - це платформа з відкритим вихідним кодом для управління контейнеризованими робочими навантаженнями та супутніми службами. Її основні характеристики - кросплатформенність, розширюваність, успішне використання декларативної конфігурації та автоматизації. Вона має гігантську, швидкопрогресуючу екосистему.
Назва Kubernetes походить з грецької та означає керманич або пілот. Google відкрив доступ до вихідного коду проекту Kubernetes у 2014 році. Kubernetes побудовано на базі п'ятнадцятирічного досвіду, що Google отримав, оперуючи масштабними робочими навантаженнями у купі з найкращими у своєму класі ідеями та практиками, які може запропонувати спільнота.
Озираючись на першопричини
Повернімось назад у часі та дізнаємось, завдяки чому Kubernetes став таким корисним.
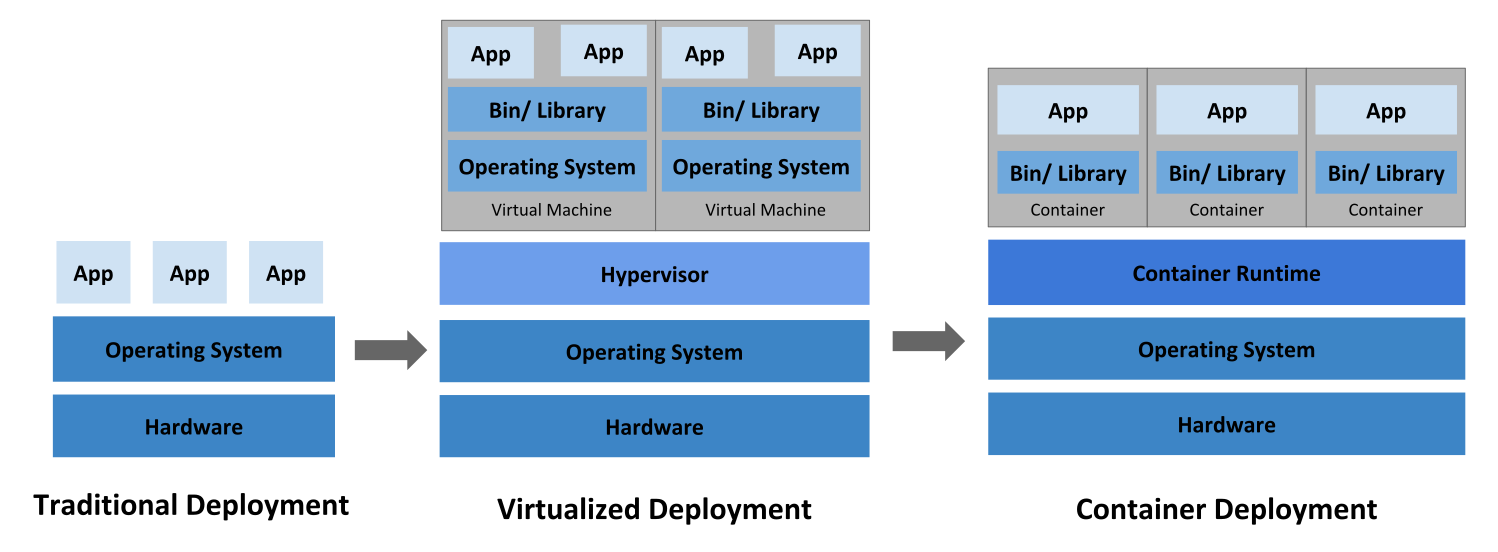
Ера традиційного розгортання: На початку організації запускали застосунки на фізичних серверах. Оскільки в такий спосіб не було можливості задати обмеження використання ресурсів, це спричиняло проблеми виділення та розподілення ресурсів на фізичних серверах. Наприклад: якщо багато застосунків було запущено на фізичному сервері, могли траплятись випадки, коли один застосунок забирав собі найбільше ресурсів, внаслідок чого інші програми просто не справлялись з обов'язками. Рішенням може бути запуск кожного застосунку на окремому фізичному сервері. Але такий підхід погано масштабується, оскільки ресурси не повністю використовуються; на додачу, це дорого, оскільки організаціям потрібно опікуватись багатьма фізичними серверами.
Ера віртуалізованого розгортання: Як рішення - була представлена віртуалізація. Вона дозволяє запускати численні віртуальні машини (Virtual Machines або VMs) на одному фізичному ЦПУ сервера. Віртуалізація дозволила застосункам бути ізольованими у межах віртуальних машин та забезпечувала безпеку, оскільки інформація застосунку на одній VM не була доступна застосунку на іншій VM.
Віртуалізація забезпечує краще використання ресурсів на фізичному сервері та кращу масштабованість, оскільки дозволяє легко додавати та оновлювати застосунки, зменшує витрати на фізичне обладнання тощо. З віртуалізацією ви можете представити ресурси у вигляді одноразових віртуальних машин.
Кожна VM є повноцінною машиною з усіма компонентами, включно з власною операційною системою, що запущені поверх віртуалізованого апаратного забезпечення.
Ера розгортання контейнерів: Контейнери схожі на VM, але мають спрощений варіант ізоляції і використовують спільну операційну систему для усіх застосунків. Саме тому контейнери вважаються "легкими", в порівнянні з віртуалками. Подібно до VM, контейнер має власну файлову систему, ЦПУ, пам'ять, простір процесів тощо. Оскільки контейнери вивільнені від підпорядкованої інфраструктури, їх можна легко переміщати між хмарними провайдерами чи дистрибутивами операційних систем.
Контейнери стали популярними, бо надавали додаткові переваги, такі як:
- Створення та розгортання застосунків за методологією Agile: спрощене та більш ефективне створення образів контейнерів у порівнянні до використання образів віртуальних машин.
- Безперервна розробка, інтеграція та розгортання: забезпечення надійних та безперервних збирань образів контейнерів, їх швидке розгортання та легкі відкатування (за рахунок незмінності образів).
- Розподіл відповідальності команд розробки та експлуатації: створення образів контейнерів застосунків під час збирання/релізу на противагу часу розгортання, і як наслідок, вивільнення застосунків із інфраструктури.
- Спостереження не лише за інформацією та метриками на рівні операційної системи, але й за станом застосунку та іншими сигналами.
- Однорідність середовища для розробки, тестування та робочого навантаження: запускається так само як на робочому комп'ютері, так і у хмарного провайдера.
- ОС та хмарна кросплатформність: запускається на Ubuntu, RHEL, CoreOS, у власному дата-центрі, у Google Kubernetes Engine і взагалі будь-де.
- Керування орієнтоване на застосунки: підвищення рівня абстракції від запуску операційної системи у віртуальному апаратному забезпеченні до запуску застосунку в операційній системі, використовуючи логічні ресурси.
- Нещільно зв'язані, розподілені, еластичні, вивільнені мікросервіси: застосунки розбиваються на менші, незалежні частини для динамічного розгортання та управління, на відміну від монолітної архітектури, що працює на одній великій виділеній машині.
- Ізоляція ресурсів: передбачувана продуктивність застосунку.
- Використання ресурсів: висока ефективність та щільність.
Чому вам потрібен Kubernetes і що він може робити
Контейнери - це прекрасний спосіб упакувати та запустити ваші застосунки. У прод оточенні вам потрібно керувати контейнерами, в яких працюють застосунки, і стежити, щоб не було простою. Наприклад, якщо один контейнер припиняє роботу, інший має бути запущений йому на заміну. Чи не легше було б, якби цим керувала сама система?
Ось де Kubernetes приходить на допомогу! Kubernetes надає вам каркас для еластичного запуску розподілених систем. Він опікується масштабуванням та аварійним відновленням вашого застосунку, пропонує шаблони розгортань тощо. Наприклад, Kubernetes дозволяє легко створювати розгортання за стратегією canary у вашій системі.
Kubernetes надає вам:
- Виявлення сервісів та балансування навантаження Kubernetes може надавати доступ до контейнера, використовуючи DNS-ім'я або його власну IP-адресу. Якщо контейнер зазнає завеликого мережевого навантаження, Kubernetes здатний збалансувати та розподілити його таким чином, щоб якість обслуговування залишалась стабільною.
- Оркестрація сховища інформації Kubernetes дозволяє вам автоматично монтувати системи збереження інформації на ваш вибір: локальні сховища, рішення від хмарних провайдерів тощо.
- Автоматичне розгортання та відкатування За допомогою Kubernetes ви можете описати бажаний стан контейнерів, що розгортаються, і він регульовано простежить за виконанням цього стану. Наприклад, ви можете автоматизувати в Kubernetes процеси створення нових контейнерів для розгортання, видалення існуючих контейнерів і передачу їхніх ресурсів на новостворені контейнери.
- Автоматичне розміщення задач Ви надаєте Kubernetes кластер для запуску контейнерізованих задач і вказуєте, скільки ресурсів ЦПУ та пам'яті (RAM) необхідно для роботи кожного контейнера. Kubernetes розподіляє контейнери по вузлах кластера для максимально ефективного використання ресурсів.
- Самозцілення Kubernetes перезапускає контейнери, що відмовили; заміняє контейнери; зупиняє роботу контейнерів, що не відповідають на задану користувачем перевірку стану, і не повідомляє про них клієнтам, допоки ці контейнери не будуть у стані робочої готовності.
- Управління секретами та конфігурацією Kubernetes дозволяє вам зберігати та керувати чутливою інформацією, такою як паролі, OAuth токени та SSH ключі. Ви можете розгортати та оновлювати секрети та конфігурацію без перезбирання образів ваших контейнерів, не розкриваючи секрети в конфігурацію стека.
Чим не є Kubernetes
Kubernetes не є комплексною системою PaaS (Платформа як послуга) у традиційному розумінні. Оскільки Kubernetes оперує швидше на рівні контейнерів, аніж на рівні апаратного забезпечення, деяка загальнозастосована функціональність і справді є спільною з PaaS, як-от розгортання, масштабування, розподіл навантаження, логування і моніторинг. Водночас Kubernetes не є монолітним, а вищезазначені особливості підключаються і є опціональними. Kubernetes надає будівельні блоки для створення платформ для розробників, але залишає за користувачем право вибору у важливих питаннях.
Kubernetes:
- Не обмежує типи застосунків, що підтримуються. Kubernetes намагається підтримувати найрізноманітніші типи навантажень, включно із застосунками зі станом (stateful) та без стану (stateless), навантаження по обробці даних тощо. Якщо ваш застосунок можна контейнеризувати, він чудово запуститься під Kubernetes.
- Не розгортає застосунки з вихідного коду та не збирає ваші застосунки. Процеси безперервної інтеграції, доставки та розгортання (CI/CD) визначаються на рівні організації, та в залежності від технічних вимог.
- Не надає сервіси на рівні застосунків як вбудовані: програмне забезпечення проміжного рівня (наприклад, шина передачі повідомлень), фреймворки обробки даних (наприклад, Spark), бази даних (наприклад, MySQL), кеш, некластерні системи збереження інформації (наприклад, Ceph). Ці компоненти можуть бути запущені у Kubernetes та/або бути доступними для застосунків за допомогою спеціальних механізмів, наприклад Open Service Broker.
- Не нав'язує використання інструментів для логування, моніторингу та сповіщень, натомість надає певні інтеграційні рішення як прототипи, та механізми зі збирання та експорту метрик.
- Не надає та не змушує використовувати якусь конфігураційну мову/систему (як наприклад
Jsonnet), натомість надає можливість використовувати API, що може бути використаний довільними формами декларативних специфікацій. - Не надає і не запроваджує жодних систем машинної конфігурації, підтримки, управління або самозцілення.
- На додачу, Kubernetes - не просто система оркестрації. Власне кажучи, вона усуває потребу оркестрації як такої. Технічне визначення оркестрації - це запуск визначених процесів: спочатку A, за ним B, потім C. На противагу, Kubernetes складається з певної множини незалежних, складних процесів контролерів, що безперервно опрацьовують стан у напрямку, що заданий бажаною конфігурацією. Неважливо, як ви дістанетесь з пункту A до пункту C. Централізоване управління також не є вимогою. Все це виливається в систему, яку легко використовувати, яка є потужною, надійною, стійкою та здатною до легкого розширення.
Що далі
- Перегляньте компоненти Kubernetes
- Готові розпочати роботу?
3 - Обʼєкти в Kubernetes
Ця сторінка пояснює, як обʼєкти Kubernetes подаються в API Kubernetes, та як ви можете описати їх у форматі .yaml.
Розуміння обʼєктів Kubernetes
Обʼєкти Kubernetes є постійними сутностями в системі Kubernetes. Kubernetes використовує ці сутності для подання стану вашого кластера. Зокрема, вони можуть описувати:
- Які контейнеризовані застосунки працюють (і на яких вузлах)
- Ресурси, доступні для цих застосунків
- Політики щодо того, як ці застосунки поводяться, такі як політики перезапуску, оновлення та стійкості до відмов
Обʼєкт Kubernetes є "записом про наміри" — після створення обʼєкта система Kubernetes постійно працюватиме, щоб переконатися, що обʼєкт існує. Створюючи обʼєкт, ви фактично повідомляєте системі Kubernetes ваші побажання щодо того, як має виглядати робоче навантаження вашого кластера; це бажаний стан вашого кластера.
Для роботи з обʼєктами Kubernetes — чи то для створення, зміни чи видалення — вам потрібно використовувати API Kubernetes. Наприклад, коли ви використовуєте інтерфейс командного рядка kubectl, CLI виконує необхідні виклики API Kubernetes за вас. Ви також можете використовувати API Kubernetes безпосередньо у ваших власних програмах за допомогою однієї з клієнтських бібліотек.
Специфікація та стан обʼєкта
Майже кожен обʼєкт Kubernetes містить два вкладених поля обʼєкта, які керують конфігурацією обʼєкта: spec та status обʼєкта. Для обʼєктів, які мають spec, вам потрібно встановити його під час створення обʼєкта, надаючи опис характеристик, які ви хочете, щоб ресурс мав: його бажаний стан.
status описує поточний стан обʼєкта, який надається та оновлюється системою Kubernetes та її компонентами. Панель управління Kubernetes постійно та активно керує фактичним станом кожного обʼєкта, щоб він відповідав бажаному стану, який ви вказали.
Наприклад: у Kubernetes Deployment є обʼєктом, який може представляти застосунок, який працює на вашому кластері. При створенні Deployment ви можете встановити spec Deployment, щоб вказати, що ви хочете, щоб працювало три репліки застосунку. Система Kubernetes читає spec Deployment та запускає три екземпляри вашого застосунку, оновлюючи status відповідно до вашого spec. Якщо один із цих екземплярів зазнає збою (зміна стану), система Kubernetes реагує на відмінність між spec та status, вносячи виправлення: у цьому випадку запускаючи екземпляр на заміну.
З докладнішою інформацією про spec, status та metadata обʼєктів Kubernetes звертайтесь до Kubernetes API Conventions.
Опис обʼєктів Kubernetes
Коли ви створюєте обʼєкт Kubernetes, ви повинні визначити spec обʼєкта, який описує бажаний стан обʼєкта, а також деякі основні відомості про обʼєкт, наприклад його назву (name). Коли ви використовуєте API Kubernetes для створення обʼєкта, чи безпосередньо, чи за допомогою kubectl, цей запит до API має містити ці відомості у вигляді JSON в тілі запиту. Найчастіше інформація про обʼєкт подається kubectl у вигляді файлу, який називається маніфестом. За домовленістю, маніфести обʼєктів Kubernetes подаються у форматі YAML (ви також можете використовувати JSON). Інструменти, такі як kubectl, перетворюють інформацію з маніфесту у JSON або інший підтримуваний формат серіалізації, надсилаючи HTTP-запити до API.
Ось приклад маніфесту, який містить обовʼязкові поля обʼєкта та його spec для Kubernetes Deployment:

apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
spec:
  selector:
    matchLabels:
      app: nginx
  replicas: 2 # tells deployment to run 2 pods matching the template
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.14.2
        ports:
        - containerPort: 80
Один зі способів створення Deployment за допомогою маніфесту, подібного до показаного вище, — використання команди kubectl apply в інтерфейсі командного рядка kubectl, передаючи файл .yaml як аргумент. Ось приклад:
kubectl apply -f https://k8s.io/examples/application/deployment.yaml
Вивід буде схожий на цей:
deployment.apps/nginx-deployment created
Обовʼязкові поля
В маніфесті (файл YAML або JSON) обʼєкта Kubernetes, який ви хочете створити, ви повинні вказати значення для таких полів:
apiVersion— версія API Kubernetes, яку ви використовуєте для створення обʼєктаkind— тип обʼєкта, який ви хочете створитиmetadata— дані, які допомагають унікально ідентифікувати обʼєкт, включаючи рядокname,UIDта, необовʼязково,namespacespec— опис бажаного стану обʼєкта
Точний формат spec обʼєкта є різним для кожного типу обʼєкта в Kubernetes та містить вкладені поля, що притаманні конкретному типу обʼєкта. Довідник API Kubernetes може допомогти знайти формат spec для всіх типів обʼєктів, які ви можете створити за допомогою Kubernetes.
Наприклад, подивіться на поле spec для обʼєкта Pod. Для кожного Podʼа поле .spec описує Pod та його бажаний стан (наприклад, назву образу контейнера для кожного контейнера всередині цього Podʼа). Інший приклад специфікації обʼєкта — поле spec для обʼєкта StatefulSet. Для StatefulSet поле .spec описує StatefulSet та його бажаний стан. У .spec StatefulSet є шаблон для обʼєктів Pod. Цей шаблон описує Podʼи, які контролер StatefulSet створить, щоб задовольнити специфікацію StatefulSet. Різні типи обʼєктів Kubernetes можуть мати різні .status; дивіться довідник API Kubernetes для отримання відомостей про структуру поля .status та його вміст для кожного типу обʼєкта.
Додаткову інформацію про написання конфігураційних файлів YAML дивіться в Рекомендаціях щодо конфігурації Kubernetes.
Перевірка полів на стороні сервера
Починаючи з Kubernetes v1.25, API-сервер надає перевірку полів на стороні сервера, яка виявляє невідомі та дубльовані поля в обʼєкті. Це надає всю функціональність kubectl --validate на стороні сервера.
kubectl використовує прапорець --validate для встановлення рівня перевірки полів маніфесту. Його значенням може бути ignore, warn та strict, також можна вказати true (еквівалент strict) та false (еквівалент ignore). Типове значення перевірки для kubectl — --validate=true.
Strict- Сувора перевірка, повертає збій під час виявлення помилок.
Warn- Перевірка виконується, але виявлення помилок призводить до виведення попереджень, а не збою.
Ignore- Перевірка на стороні сервера не виконується.
Якщо kubectl не може підʼєднатися до API-сервера, який підтримує перевірку полів, він використовує перевірку на стороні клієнта. Kubernetes v1.27 та пізніші версії завжди пропонуватимуть перевірку полів; версії до v1.27, скоріш за все — ні. Якщо версія Kubernetes на вашому кластері старіша за v1.27, звіртесь з документацією до вашої версії Kubernetes.
Що далі
Якщо ви тільки починаєте свій шлях в Kubernetes, дізнайтесь більше про:
- Podʼи — найважливіші базові обʼєкти в Kubernetes.
- Обʼєкти Deployment.
- Контролери в Kubernetes.
- kubectl та команди
kubectl.
Керування обʼєктами в Kubernetes надає додаткову інформацію про те, як використовувати kubectl для керування обʼєктами. Можливо, вам потрібно буде встановити kubectl, якщо його у вас ще немає.
Щоб дізнатись про API Kubernetes, зверніться до:
Щоб глибше ознайомитися з обʼєктами в Kubernetes, прочитайте інші сторінки цього розділу:
3.1 - Управління обʼєктами Kubernetes
Інструмент командного рядка kubectl підтримує кілька різних способів створення та управління обʼєктами Kubernetes. Цей документ надає огляд різних підходів. Для отримання деталей щодо управління обʼєктами за допомогою Kubectl читайте Книгу Kubectl.
Техніки управління
Попередження:
Обʼєкт Kubernetes повинен управлятися лише з використанням однієї техніки. Змішування різних технік для того самого обʼєкта призводить до невизначеної поведінки.| Техніка управління | Діє на | Рекомендоване середовище | Підтримувані автори змін | Крива навчання |
|---|---|---|---|---|
| Імперативні команди | Живі обʼєкти | Проєкти розробки | 1+ | Найлегша |
| Імперативна конфігурація обʼєктів | Окремі файли | Промислові проєкти | 1 | Середня |
| Декларативна конфігурація обʼєктів | Теки файлів | Промислові проєкти | 1+ | Найскладніша |
Імперативні команди
Під час використання імперативних команд користувач працює безпосередньо з живими обʼєктами в кластері. Користувач надає операції команді kubectl у вигляді аргументів чи прапорців.
Це рекомендований спосіб початку роботи або виконання одноразового завдання в кластері. Оскільки цей метод працює безпосередньо з живими обʼєктами, він не зберігає історії попередніх конфігурацій.
Приклади
Запустіть екземпляр контейнера nginx, створивши обʼєкт Deployment:
kubectl create deployment nginx --image nginx
Компроміси
Переваги порівняно із конфігуруванням обʼєктів:
- Команди виражені як одне слово дії.
- Команди вимагають лише одного кроку для внесення змін до кластера.
Недоліки порівняно із конфігуруванням обʼєктів:
- Команди не інтегруються з процесами перегляду змін.
- Команди не надають журналу аудиту, повʼязаного зі змінами.
- Команди не надають джерела записів, окрім самих живих обʼєктів.
- Команди не надають шаблону для створення нових обʼєктів.
Імперативне конфігурування обʼєктів
В імперативній конфігурації обʼєктів команда kubectl вказує операцію (create, replace тощо), необовʼязкові прапорці та принаймні одне імʼя файлу. Зазначений файл повинен містити повне визначення обʼєкта у форматі YAML або JSON.
Див. API-довідник для отримання докладніших відомостей щодо визначення обʼєктів.
Попередження:
Імперативна командаreplace замінює поточну специфікацію на нову, відкидаючи всі зміни обʼєкта, яких немає у файлі конфігурації. Цей підхід не повинен використовуватися із типами ресурсів, специфікації яких оновлюються незалежно від файлу конфігурації. Наприклад, у Services типу LoadBalancer поле externalIPs оновлюється кластером незалежно від файлу конфігурації.Приклади
Створити обʼєкти, визначені у файлі конфігурації:
kubectl create -f nginx.yaml
Видалити обʼєкти, визначені у двох файлах конфігурації:
kubectl delete -f nginx.yaml -f redis.yaml
Оновити обʼєкти, визначені у файлі конфігурації, перезаписавши живу конфігурацію:
kubectl replace -f nginx.yaml
Компроміси
Переваги порівняно з імперативними командами:
- Конфігурація обʼєктів може зберігатися у системі контролю версій, такій як Git.
- Конфігурація обʼєктів може інтегруватися з процесами, такими як перегляд змін перед надсиланням (push) та журнали аудиту.
- Конфігурація обʼєктів надає шаблон для створення нових обʼєктів.
Недоліки порівняно з імперативними командами:
- Конфігурація обʼєктів потребує базового розуміння схеми обʼєкта.
- Конфігурація обʼєктів потребує додаткового кроку у вигляді написання файлу YAML.
Переваги порівняно із декларативною конфігурацією обʼєктів:
- Поведінка імперативної конфігурації обʼєктів простіша та її легше зрозуміти.
- Станом на версію Kubernetes 1.5 імперативна конфігурація обʼєктів є більш зрілою.
Недоліки порівняно із декларативною конфігурацією обʼєктів:
- Імперативна конфігурація обʼєктів працює краще з файлами, а не з теками.
- Оновлення живих обʼєктів мають відображатися у файлах конфігурації, інакше вони будуть втрачені під час наступної заміни.
Декларативна конфігурація обʼєктів
Під час використання декларативної конфігурації обʼєктів користувач працює з конфігураційними файлами обʼєктів, збереженими локально, проте користувач не визначає операції, які слід виконати над файлами. Операції створення, оновлення та видалення автоматично визначаються для кожного обʼєкта за допомогою kubectl. Це дозволяє працювати з теками, де для різних обʼєктів можуть бути потрібні різні операції.
Примітка:
Декларативна конфігурація обʼєктів зберігає зміни, внесені іншими авторами, навіть якщо зміни не зливаються назад у файл конфігурації обʼєкта. Це можливо за допомогою використання операції APIpatch для запису тільки виявлених відмінностей, замість використання операції API replace для заміни всього файлу конфігурації обʼєкта.Приклади
Обробити всі файли конфігурації обʼєктів у теці configs та створити або внести патчі до живих обʼєктів. Спочатку ви можете використовувати diff, щоб побачити, які зміни будуть внесені, а потім застосувати їх:
kubectl diff -f configs/
kubectl apply -f configs/
Рекурсивно обробити теки:
kubectl diff -R -f configs/
kubectl apply -R -f configs/
Компроміси
Переваги порівняно з імперативною конфігурацією обʼєктів:
- Зміни, внесені безпосередньо в живі обʼєкти, зберігаються, навіть якщо вони не зливаються назад у файли конфігурації.
- Декларативна конфігурація обʼєктів краще підтримує роботу з теками та автоматично визначає типи операцій (створення, патч, видалення) для кожного обʼєкта.
Недоліки порівняно з імперативною конфігурацією обʼєктів:
- Декларативну конфігурацію обʼєктів важче налагоджувати, а її результати важче зрозуміти, коли вони неочікувані.
- Часткові оновлення за допомогою diffs створюють складні операції злиття та накладання патчів.
Що далі
- Управління обʼєктами Kubernetes за допомогою імперативних команд
- Імперативне управління обʼєктами Kubernetes за допомогою файлів конфігурації
- Декларативне управління обʼєктами Kubernetes за допомогою файлів конфігурації
- Декларативне управління обʼєктами Kubernetes за допомогою Kustomize
- Довідник команд Kubectl
- Книга Kubectl
- Довідник API Kubernetes
3.2 - Назви та ідентифікатори обʼєктів
Кожен обʼєкт у вашому кластері має Назву, яка є унікальною для цього типу ресурсу. Кожен обʼєкт Kubernetes також має UID, який є унікальним в усьому вашому кластері.
Наприклад, ви можете мати лише один обʼєкт Pod із назвою myapp-1234 в одному й тому самому просторі імен, а також ви можете мати один обʼєкт Pod та один Deployment із назвами myapp-1234 кожен.
Для неунікальних атрибутів, наданих користувачем, Kubernetes надає мітки (labels) та анотації (annotations).
Назви
Наданий клієнтом рядок, який посилається на обʼєкт в URL ресурсу, наприклад /api/v1/pods/some-name.
Водночас лише один обʼєкт певного виду (kind) може мати певну назву. Проте якщо ви видалите обʼєкт, ви можете створити новий обʼєкт з такою самою назвою.
Назви повинні бути унікальними між усіма версіями API того самого ресурсу.
Kubernetes унікально ідентифікує обʼєкти за допомогою комбінації чотирьох атрибутів:
- Група API (наприклад,
apps) - Тип ресурсу (наприклад,
deployments) - Простір імен (для ресурсів із просторами імен)
- Назва
Хоча ви можете отримати доступ до ресурсу через різні версії API (наприклад, v1 або v1beta1), версія є просто іншим представленням того самого базового обʼєкта. Оскільки версія не є частиною унікальної ідентифікації, ви не можете створити два обʼєкти з однаковою назвою та типом ресурсу в одному просторі імен, використовуючи різні версії API.
Примітка:
У випадках, коли обʼєкти представляють фізичний обʼєкт, наприклад, Node, що представляє фізичний хост, коли хост створюється заново з тією самою назвою без видалення та повторного створення Node, Kubernetes розглядає новий хост як старий, що може призвести до неузгодженостей.Сервер може згенерувати назву, якщо в запиті на створення ресурсу замість name вказати generateName. Коли використовується generateName, надане значення використовується як префікс назви, до якого сервер додає згенерований суфікс. Навіть якщо назву згенеровано, вона може конфліктувати з наявними назвами, що призведе до відповіді HTTP 409. Це стало набагато менш імовірним в Kubernetes v1.31 і пізніших версіях, оскільки сервер зробить до 8 спроб згенерувати унікальну назву перед тим, як повернути відповідь HTTP 409.
Нижче наведено чотири типи обмежень на назви ресурсів, які часто використовуються.
Назви DNS-піддоменів
Більшість типів ресурсів потребують назви, яку можна використовувати як DNS-піддомен згідно з RFC 1123. Це означає, що назва повинна:
- містити не більше 253 символів
- містити лише буквено-цифрові символи, '-' чи '.' в нижньому регістрі
- починатися буквено-цифровим символом
- закінчуватися буквено-цифровим символом
Назви міток RFC 1123
Деякі типи ресурсів вимагають, щоб їх назви відповідали стандарту міток DNS, як визначено в RFC 1123. Це означає, що назва повинна:
- містити не більше 63 символів
- містити лише буквено-цифрові символи чи '-' в нижньому регістрі
- починатися алфавітним символом
- закінчуватися буквено-цифровим символом
Примітка:
Коли увімкнено функціональну можливістьRelaxedServiceNameValidation, назви обʼєктів Service можуть починатися з цифри.Назви міток RFC 1035
Деякі типи ресурсів вимагають, щоб їх назви відповідали стандарту міток DNS, як визначено в RFC 1035. Це означає, що назва повинна:
- містити не більше 63 символів
- містити лише буквено-цифрові символи чи '-' в нижньому регістрі
- починатися алфавітним символом
- закінчуватися буквено-цифровим символом
Примітка:
Хоча RFC 1123 технічно дозволяє міткам починатися з цифри, поточна реалізація Kubernetes вимагає, щоб мітки як RFC 1035, так і RFC 1123 починалися з літери. Винятком є увімкнення функціональної можливостіRelaxedServiceNameValidation для обʼєктів Service, що дозволяє назвам Service починатися з цифри.Назви сегментів шляху
Деякі типи ресурсів вимагають, щоб їх назви можна було безпечно кодувати як сегмент шляху. Іншими словами, назва не може бути "." або "..", і вона не може містити "/" або "%".
Ось приклад маніфесту для Pod із назвою nginx-demo.
apiVersion: v1
kind: Pod
metadata:
  name: nginx-demo
spec:
  containers:
  - name: nginx
    image: nginx:1.14.2
    ports:
    - containerPort: 80
Примітка:
Деякі типи ресурсів мають додаткові обмеження на їх назви.UID
Рядок, створений системами Kubernetes для унікальної ідентифікації обʼєктів.
Кожен обʼєкт, створений протягом усього життя кластера Kubernetes, має унікальний UID. Він призначений для розрізнення історичних екземплярів схожих сутностей.
UID Kubernetes — це універсальні унікальні ідентифікатори (також відомі як UUID). UUID стандартизовані згідно з ISO/IEC 9834-8 та ITU-T X.667.
Що далі
- Дізнайтеся більше про мітки (labels) та анотації (annotations) в Kubernetes.
- Перегляньте документ Ідентифікатори та назви в Kubernetes.
3.3 - Власники та залежності
У Kubernetes деякі обʼєкти є власниками інших обʼєктів. Наприклад, ReplicaSet є власником групи Podʼів. Ці підлеглі обʼєкти є залежними від свого власника.
Власність відрізняється від механізму міток та селекторів, який також використовують деякі ресурси. Наприклад, розгляньте Service, який створює обʼєкти EndpointSlice. Service використовує мітки, щоб панель управління могла визначити, які обʼєкти EndpointSlice використовуються для цього Service. Крім міток, кожен EndpointSlice, керований від імені Service, має посилання на власника. Посилання на власника допомагають різним частинам Kubernetes уникати втручання в обʼєкти, якими вони не керують.
Посилання на власника в специфікаціях обʼєктів
Залежні обʼєкти мають поле metadata.ownerReferences, яке містить посилання на їх власника. Дійсне посилання на власника складається з назви обʼєкта та UID в межах того ж простору імен, що й залежний обʼєкт. Kubernetes автоматично встановлює значення цього поля для обʼєктів, які є залежностями інших обʼєктів, таких як ReplicaSets, DaemonSets, Deployments, Jobs та CronJobs, та ReplicationControllers. Ви також можете налаштувати ці звʼязки вручну, змінивши значення цього поля. Однак зазвичай цього не потрібно робити, і можна дозволити Kubernetes автоматично керувати цими звʼязками.
Залежні обʼєкти також мають поле ownerReferences.blockOwnerDeletion, яке має булеве значення і контролює, чи можуть певні залежні обʼєкти блокувати збір сміття, що видаляє їх власника. Kubernetes автоматично встановлює це поле в true, якщо контролер (наприклад, контролер Deployment) встановлює значення поля metadata.ownerReferences. Ви також можете встановити значення поля blockOwnerDeletion вручну, щоб контролювати, які залежні обʼєкти блокують збір сміття.
Контролер допуску Kubernetes контролює доступ користувачів до зміни цього поля для залежних ресурсів на основі прав видалення власника. Цей контроль перешкоджає несанкціонованим користувачам затримувати видалення обʼєкта-власника.
Примітка:
Посилання на власника з іншого простору імен заборонені за задумом. Залежні обʼєкти в межах простору імен можуть вказувати власників рівня кластера або рівня простору імен. Власник рівня простору імен повинен існувати в тому самому просторі імен, що й залежний обʼєкт. Якщо це не так, посилання на власника вважається відсутнім, і залежний обʼєкт підлягає видаленню після перевірки відсутності всіх власників.
Залежні обʼєкти рівня кластера можуть вказувати тільки власників рівня кластера. У v1.20+, якщо залежний обʼєкт рівня кластера вказує як власника тип у межах простору імен, вважається, що він має нерозвʼязне посилання на власника, і його не можна прибрати збором сміття.
У v1.20+, якщо збирач сміття виявляє недійсний ownerReference між просторами імен або залежний обʼєкт рівня кластера з ownerReference, що посилається на тип у межах простору імен, повідомляється про попереджувальну подію з причиною OwnerRefInvalidNamespace та involvedObject недійсного залежного елемента. Ви можете перевірити наявність такого роду подій (Event), запустивши kubectl get events -A --field-selector=reason=OwnerRefInvalidNamespace.
Власність та завершувачі
Коли ви наказуєте Kubernetes видалити ресурс, API-сервер дозволяє контролеру, що керує ресурсом, обробити будь-які правила завершувача для ресурсу. Завершувачі запобігають випадковому видаленню ресурсів, які вашому кластеру можуть ще бути потрібні для коректної роботи. Наприклад, якщо ви намагаєтеся видалити PersistentVolume, який все ще використовується Podʼом, видалення не відбувається негайно, оскільки PersistentVolume має завершувач kubernetes.io/pv-protection. Замість цього том залишається в стані Terminating до тих пір, поки Kubernetes не очистить завершувач, що відбувається тільки після того, як PersistentVolume більше не привʼязаний до Podʼа.
Kubernetes також додає завершувачі до ресурсу-власника, коли ви використовуєте або каскадне видалення на передньому плані або каскадне видалення сиріт. Під час видалення на передньому плані додається завершувач foreground, так що контролер повинен видалити залежні ресурси, які також мають ownerReferences.blockOwnerDeletion=true, перш ніж він видалить власника. Якщо ви вказуєте політику видалення покинутих ресурсів (сиріт), Kubernetes додає завершувач orphan, так що контролер ігнорує залежні ресурси після того, як він видаляє обʼєкт-власника.
Що далі
- Дізнайтеся більше про завершувачі Kubernetes.
- Дізнайтеся про збір сміття.
- Прочитайте API-довідник про метадані обʼєкта.
3.4 - Рекомендовані мітки
Ви можете візуалізувати обʼєкти Kubernetes і керувати ними не лише за допомогою kubectl і панелі керування (dashboard), а й за допомогою інших інструментів. Загальний набір міток дозволяє інструментам працювати між собою, описуючи обʼєкти спільним чином, який можуть розуміти всі інструменти.
Крім підтримки інструментів, рекомендовані мітки описують застосунки так, що до них можна робити запити.
Метадані організовані навколо концепції застосунку. Kubernetes не є платформою як сервіс (PaaS) і не має та не навʼязує формального поняття застосунку. Замість цього застосунки є неформальними та описуються метаданими. Визначення того, що включає застосунок, є гнучким.
Примітка:
Це рекомендовані мітки. Вони полегшують управління застосунками, але не обовʼязкові для будь-яких основних інструментів.Спільні мітки та анотації мають спільний префікс: app.kubernetes.io. Мітки без префіксу є приватними для користувачів. Спільний префікс забезпечує, що спільні мітки не перешкоджають роботі власних міток користувачів.
Мітки
Щоб повною мірою скористатися цими мітками, їх слід застосовувати до кожного обʼєкта ресурсу.
| Ключ | Опис | Приклад | Тип |
|---|---|---|---|
app.kubernetes.io/name |
Назва застосунку | mysql |
рядок |
app.kubernetes.io/instance |
Унікальна назва, що ідентифікує екземпляр застосунку | mysql-abcxyz |
рядок |
app.kubernetes.io/version |
Поточна версія застосунку (наприклад, SemVer 1.0, хеш ревізії тощо) | 5.7.21 |
рядок |
app.kubernetes.io/component |
Компонент всередині архітектури | database |
рядок |
app.kubernetes.io/part-of |
Назва застосунку вищого рівня, частиною якого є цей застосунок | wordpress |
рядок |
app.kubernetes.io/managed-by |
Інструмент, який використовується для управління роботою застосунку | Helm |
рядок |
Щоб проілюструвати ці мітки в дії, розгляньте такий обʼєкт StatefulSet:
# Це уривок
apiVersion: apps/v1
kind: StatefulSet
metadata:
  labels:
    app.kubernetes.io/name: mysql
    app.kubernetes.io/instance: mysql-abcxyz
    app.kubernetes.io/version: "5.7.21"
    app.kubernetes.io/component: database
    app.kubernetes.io/part-of: wordpress
    app.kubernetes.io/managed-by: Helm
Застосунки та екземпляри застосунків
Застосунок можна встановити один або декілька разів у кластер Kubernetes і, у деяких випадках, у той самий простір імен. Наприклад, WordPress можна встановити більше одного разу, де різні вебсайти є різними екземплярами WordPress.
Назва застосунку та назва екземпляра записуються окремо. Наприклад, у WordPress є app.kubernetes.io/name — wordpress, тоді як назва екземпляра представлена як app.kubernetes.io/instance зі значенням wordpress-abcxyz. Це дозволяє ідентифікувати застосунок та його екземпляр. Кожен екземпляр застосунку повинен мати унікальну назву.
Приклади
Щоб проілюструвати різні способи використання цих міток, наведено приклади різної складності.
Простий Stateless Service
Розгляньте випадок простого Stateless Service, розгорнутого за допомогою обʼєктів Deployment та Service. Наведені нижче два уривки представляють, як можуть бути використані мітки у їх найпростішій формі.
Deployment використовується для нагляду за Podʼами, які виконують сам застосунок.
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app.kubernetes.io/name: myservice
    app.kubernetes.io/instance: myservice-abcxyz
...
Service використовується для відкриття доступу до застосунку.
apiVersion: v1
kind: Service
metadata:
  labels:
    app.kubernetes.io/name: myservice
    app.kubernetes.io/instance: myservice-abcxyz
...
Вебзастосунок із базою даних
Розгляньмо трохи складніший застосунок: вебзастосунок (WordPress) із базою даних (MySQL), встановлений за допомогою Helm. Наведені нижче уривки ілюструють початок обʼєктів, які використовуються для розгортання цього застосунку.
Початок цього Deployment використовується для WordPress:
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app.kubernetes.io/name: wordpress
    app.kubernetes.io/instance: wordpress-abcxyz
    app.kubernetes.io/version: "4.9.4"
    app.kubernetes.io/managed-by: Helm
    app.kubernetes.io/component: server
    app.kubernetes.io/part-of: wordpress
...
Service використовується для відкриття доступу до WordPress:
apiVersion: v1
kind: Service
metadata:
  labels:
    app.kubernetes.io/name: wordpress
    app.kubernetes.io/instance: wordpress-abcxyz
    app.kubernetes.io/version: "4.9.4"
    app.kubernetes.io/managed-by: Helm
    app.kubernetes.io/component: server
    app.kubernetes.io/part-of: wordpress
...
MySQL представлено як StatefulSet з метаданими як для нього, так і для застосунку, до якого він належить:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  labels:
    app.kubernetes.io/name: mysql
    app.kubernetes.io/instance: mysql-abcxyz
    app.kubernetes.io/version: "5.7.21"
    app.kubernetes.io/managed-by: Helm
    app.kubernetes.io/component: database
    app.kubernetes.io/part-of: wordpress
...
Service використовується для відкриття доступу до MySQL як частини WordPress:
apiVersion: v1
kind: Service
metadata:
  labels:
    app.kubernetes.io/name: mysql
    app.kubernetes.io/instance: mysql-abcxyz
    app.kubernetes.io/version: "5.7.21"
    app.kubernetes.io/managed-by: Helm
    app.kubernetes.io/component: database
    app.kubernetes.io/part-of: wordpress
...
Зверніть увагу, що StatefulSet та Service для MySQL містять інформацію як про MySQL, так і про WordPress, ширший застосунок.
3.5 - Версії зберігання
API-сервер Kubernetes зберігає обʼєкти, покладаючись на etcd-сумісне сховище (часто це сам etcd). Кожен обʼєкт серіалізується за допомогою певної версії типу API; наприклад, представлення v1 ConfigMap. Kubernetes використовує термін версія зберігання для опису того, як зберігається обʼєкт у вашому кластері.
API Kubernetes також покладається на автоматичне перетворення; наприклад, якщо у вас є HorizontalPodAutoscaler, то ви можете взаємодіяти з цим HorizontalPodAutoscaler, використовуючи будь-яку комбінацію версій v1 та v2 API HorizontalPodAutoscaler. Kubernetes відповідає за перетворення кожного API-запиту, щоб клієнти не бачили, яка версія насправді серіалізується.
Для адміністраторів кластерів версія зберігання обʼєкта є важливим поняттям для розуміння, оскільки саме вона звʼязує представлення обʼєкта у API з фактичним кодуванням у бекенді сховища. Це може бути важливим у разі, коли певне бінарне кодування обʼєкта має значення, наприклад для шифрування в стані спокою або визнання API застарілим.
Той самий API може мати кілька версій зберігання, які API-сервер може перетворювати на схему обʼєкта. Один обʼєкт, що є частиною цього ресурсу, повинен мати лише одну версію зберігання в будь-який момент часу. Це означає, що API-сервер знає бінарне кодування обʼєктів і може виконувати динамічне перетворення між всіма збереженими версіями до представлення обʼєкта у API.
Версія обʼєкта є повністю відокремленою від версії зберігання. Наприклад, API-обʼєкти v1alpha1 та v1beta1 для того самого ресурсу будуть закодовані однаково в сховищі, доки версія зберігання не буде оновлена між двома обʼєктами.
Відповідність версій зберігання ресурсам
Кожен ресурс матиме 1 активну версію зберігання в будь-який момент часу, тобто будь-який запис до обʼєкта збереже обʼєкт у цій версії зберігання. Однак версію зберігання можна оновлювати, що дозволяє зберігати обʼєкти в різних версіях. Один обʼєкт зберігатиметься лише в одній версії зберігання в будь-який момент часу.
Зчитування з API-сервера конвертуватиме збережені дані в API-представлення обʼєкта. Це дозволяє старим версіям зберігання зберігатися необмежений час, доки не відбудуться оновлення обʼєкта. З іншого боку, записи конвертуватимуть збережений обʼєкт у нове представлення після оновлення.
Версії зберігання для власних ресурсів
Власні ресурси визначаються динамічно, тому їхні версії зберігання відрізняються від версій вбудованих типів Kubernetes. Вбудовані обʼєкти загалом мають своє кодування сховища, визначене окремо від їхніх типів API, де збережений обʼєкт діє як центральний елемент, а конкретна версія ресурсу не має значення, окрім того, що це поле у схемі обʼєкта.
Однак для власних ресурсів певну версію ресурсу необхідно встановити як версію зберігання. Схема, визначена цією конкретною версією власного ресурсу, буде використовуватися як кодування ресурсу на рівні сховища. Див. розширений набір функцій CRD для отримання детальнішої інформації про налаштування API та керування версіями.
Наприклад, див. це CustomResourceDefinition для crontabs:
apiVersion: apiextensions.k8s.io/v1
kind: CustomResourceDefinition
metadata:
  name: crontabs.example.com
spec:
  group: example.com
  # перелік версій, що підтримуються цим CustomResourceDefinition
  versions:
  - name: v1beta1
    # Кожна версія може бути увімкнена/вимкнена за допомогою прапорця Served.
    served: true
    # Одна і тільки одна версія повинна бути позначена як версія зберігання.
    storage: true
    schema:
      openAPIV3Schema:
        type: object
        properties:
          host:
            type: string
          port:
            type: string
  - name: v1
    served: true
    storage: false
    schema:
      openAPIV3Schema:
        type: object
        properties:
          host:
            type: string
          port:
            type: string
          time:
            type: string
  conversion:
    strategy: None
  scope: Namespaced
  names:
    plural: crontabs
    singular: crontab
    kind: CronTab
    shortNames:
    - ct
Визначення API v1beta1 використовується як версія зберігання, тобто будь-які оновлення або створення crontabs зберігатимуться разом зі схемою обʼєкта API v1beta1. У цьому випадку це фактично означатиме, що обʼєкт API v1 ніколи не зможе зберігати поле time, оскільки воно не є частиною визначення сховища. Ця схема використовується на рівні сховища як двійкове кодування самого обʼєкта. Спроба встановити дві версії як версію, що зберігається, одночасно вважається недійсною, оскільки це означатиме, що дві схеми даних вважатимуться дійсними способами зберігання обʼєктів одночасно.
Після зміни версії, яка використовується для зберігання, ця версія API буде використовуватися для зберігання будь-яких нових або оновлених CR. Спостереження за обʼєктом або його отримання лише конвертуватиме обʼєкт зі старої версії зберігання, не змінюючи його. Тільки оновлення або створення матиме ефект і використовуватиме щойно визначену версію зберігання.
Як версії зберігання впливають на шифрування в стані спокою
Існують інструменти для шифрування сховища в стані спокою, особливо для Secrets кластера. Це додає додатковий рівень захисту від витоку даних, оскільки фактично збережені дані в кластері зашифровані. Це означає, що API-сервер фактично розшифровує дані під час їх отримання зі сховища. API-сервер повинен мати ключ для цієї версії зберігання, щоб правильно декодувати обʼєкт.
Версія зберігання в цьому випадку — це більше, ніж просто двійкове кодування обʼєкта. Якщо те, що зберігається, можна якимось чином перетворити на обʼєкт API, його можна використовувати як версію зберігання.
Міграція на іншу версію зберігання
Кілька версій зберігання для одного ресурсу можуть створювати проблеми для адміністраторів кластера. Адміністратор кластера не може видаляти старі версії API для CRD, які можуть не підтримуватися, доки не переконається, що всі обʼєкти більше не використовують повʼязану з ним версію зберігання. Через велику кількість обʼєктів та непрозоре уявлення про те, які з них є новими, а які все ще підтримуються старими версіями зберігання, важко визначити, коли версію можна безпечно видалити. Якщо версію видалено передчасно, обʼєкт може взагалі не вдатися прочитати.
Ще одним важливим питанням є використання ключів шифрування, як визначено у розділі вище. Оскільки ресурс повинен активно використовуватися для оновлення версії зберігання, після ротації ключів як старий, так і новий ключ шифрування повинні залишатися у використанні, доки адміністратор не переконається, що всі обʼєкти були записані принаймні один раз. Це створює як ризики для безпеки, так і проблеми з зручністю використання, оскільки ключ не може бути повністю вилучений з використання до того часу.
Див. міграцію версій зберігання для прикладів того, як виконати міграцію, щоб переконатися, що всі обʼєкти використовують новішу версію зберігання без ручного втручання.
4 - Інструмент командного рядка kubectl
Kubernetes надає інструмент командного рядка для взаємодії з панеллю управління кластера Kubernetes за допомогою API Kubernetes.
Інструмент kubectl взаємодіє з вашим кластером через API Kubernetes. kubectl шукає файл налаштувань з назвою config у теці $HOME/.kube. Ви можете вказати інші файли kubeconfig, встановивши змінну середовища KUBECONFIG або використавши прапорець --kubeconfig.
Роль kubectl
kubectl є основним інструментом для створення, перегляду, оновлення та видалення обʼєктів Kubernetes. Він доповнює компоненти Kubernetes, які працюють у вашому кластері, та API Kubernetes, який реалізують ці компоненти. Незалежно від того, чи запускаєте ви kubectl з вашого ноутбука, чи з Podʼа всередині кластера, він надсилає запити до API-сервера. Інші клієнти, такі як клієнтські бібліотеки та вебпанелі, такі як Headlamp, також взаємодіють через той самий API.
Як працює kubectl
Інструмент kubectl підключається до API-сервера та автентифікується за допомогою відомостей про кластер, користувача та контекст, визначених у вашому файлі kubeconfig. Коли ви запускаєте kubectl ззовні кластера, він використовує файл kubeconfig для пошуку адреси API-сервера та облікових даних. Коли kubectl працює всередині Podʼа (наприклад, у CI/CD конвеєрі), він може використовувати автентифікацію всередині кластера на основі токена ServiceAccount, змонтованого в Podʼі.
Коли ви запускаєте команду, kubectl перетворює ваші наміри на один або кілька HTTP-запитів до API Kubernetes. API-сервер перевіряє кожен запит, застосовує його до стану кластера, збереженого в etcd, і повертає результат. Це означає, що кожна дія kubectl, чи то створення Deployment, чи читання логів, проходить тим самим шляхом через API.
Оскільки ваш kubeconfig може визначати кілька кластерів, користувачів і контекстів, ви можете використовувати kubectl для перемикання між кластерами без повторного налаштування середовища. Використовуйте kubectl config use-context, щоб змінити активний контекст.
Що можна робити з kubectl
Інструмент kubectl підтримує багато операцій, які можна умовно розділити на такі категорії:
- Керування ресурсами — Створення, оновлення та видалення обʼєктів, таких як Podʼи, Deployments та Services. Використовуйте
kubectl applyдля декларативного керування за допомогою конфігураційних файлів. - Перевірка стану кластера — Перегляд списків та описів обʼєктів, подій та використання ресурсів.
- Налагодження — Перегляд логів контейнерів, виконання команд всередині запущеного контейнера або перенаправлення портів до Podʼа.
- Операції з кластером — Очищення вузлів для обслуговування, позначення вузлів як непридатних для планування, щоб запобігти появі нових навантажень, та керування конфігурацією кластера.
- Скрипти та автоматизація — Форматування виводу у JSON, YAML або власні колонки за допомогою JSONPath для використання у скриптах та конвеєрах.
Для ознайомлення з синтаксисом, довідником команд та прикладами, дивіться довідку kubectl.
Декларативне vs імперативне керування
Для робочих навантажень у промисловому середовищі рекомендується використовувати декларативне керування обʼєктами за допомогою kubectl apply з конфігураційними файлами з контролем версій. Декларативне керування допомагає відстежувати зміни, співпрацювати та інтегруватися з GitOps-процесами. Імперативні команди (такі як kubectl create або kubectl run) корисні для розробки та експериментів, але їх важче відтворювати та перевіряти.
Розширення kubectl за допомогою втулків
Ви можете розширювати kubectl за допомогою втулків, які додають нові команди. Втулки є автономними бінарними файлами, які дотримуються конвенції іменування kubectl-<назва-втулка>. Спільнота Kubernetes підтримує багато втулків, і ви можете керувати ними за допомогою менеджера втулків Krew.
Сумісність версій
Інструмент kubectl підтримує різницю версій плюс-мінус одну мінорну версію відносно панелі управління кластера. Наприклад, kubectl v1.32 працює з панелями управління в кластерах версій v1.31, v1.32 та v1.33. Використання сумісної версії запобігає непередбачуваній поведінці. Дивіться Політику версійної розбіжності для отримання деталей.
Що далі
- Ознайомтеся з довідкою kubectl для отримання відомостей про синтаксис та деталі команд.
- Встановіть kubectl на вашому компʼютері.
- Дізнайтеся про API Kubernetes, який використовує
kubectl. - Ознайомтеся з компонентами Kubernetes, які складають кластер.
- Дослідіть керування обʼєктами та декларативну конфігурацію.
- Перевірте політику версійної розбіжності для підтримуваних комбінацій версій.